深度复现 · 2026-10-23/24 · 环境:pokemon-showdown 0.11.10 / Claude Code 2.1.195 / glm-4.6 作者 + glm-4-flash 判断 · 仓库:TianyuCodings/JevHarness · 前篇:《JevHarness 实测》、《GEPA 反思环实测》
写在前面
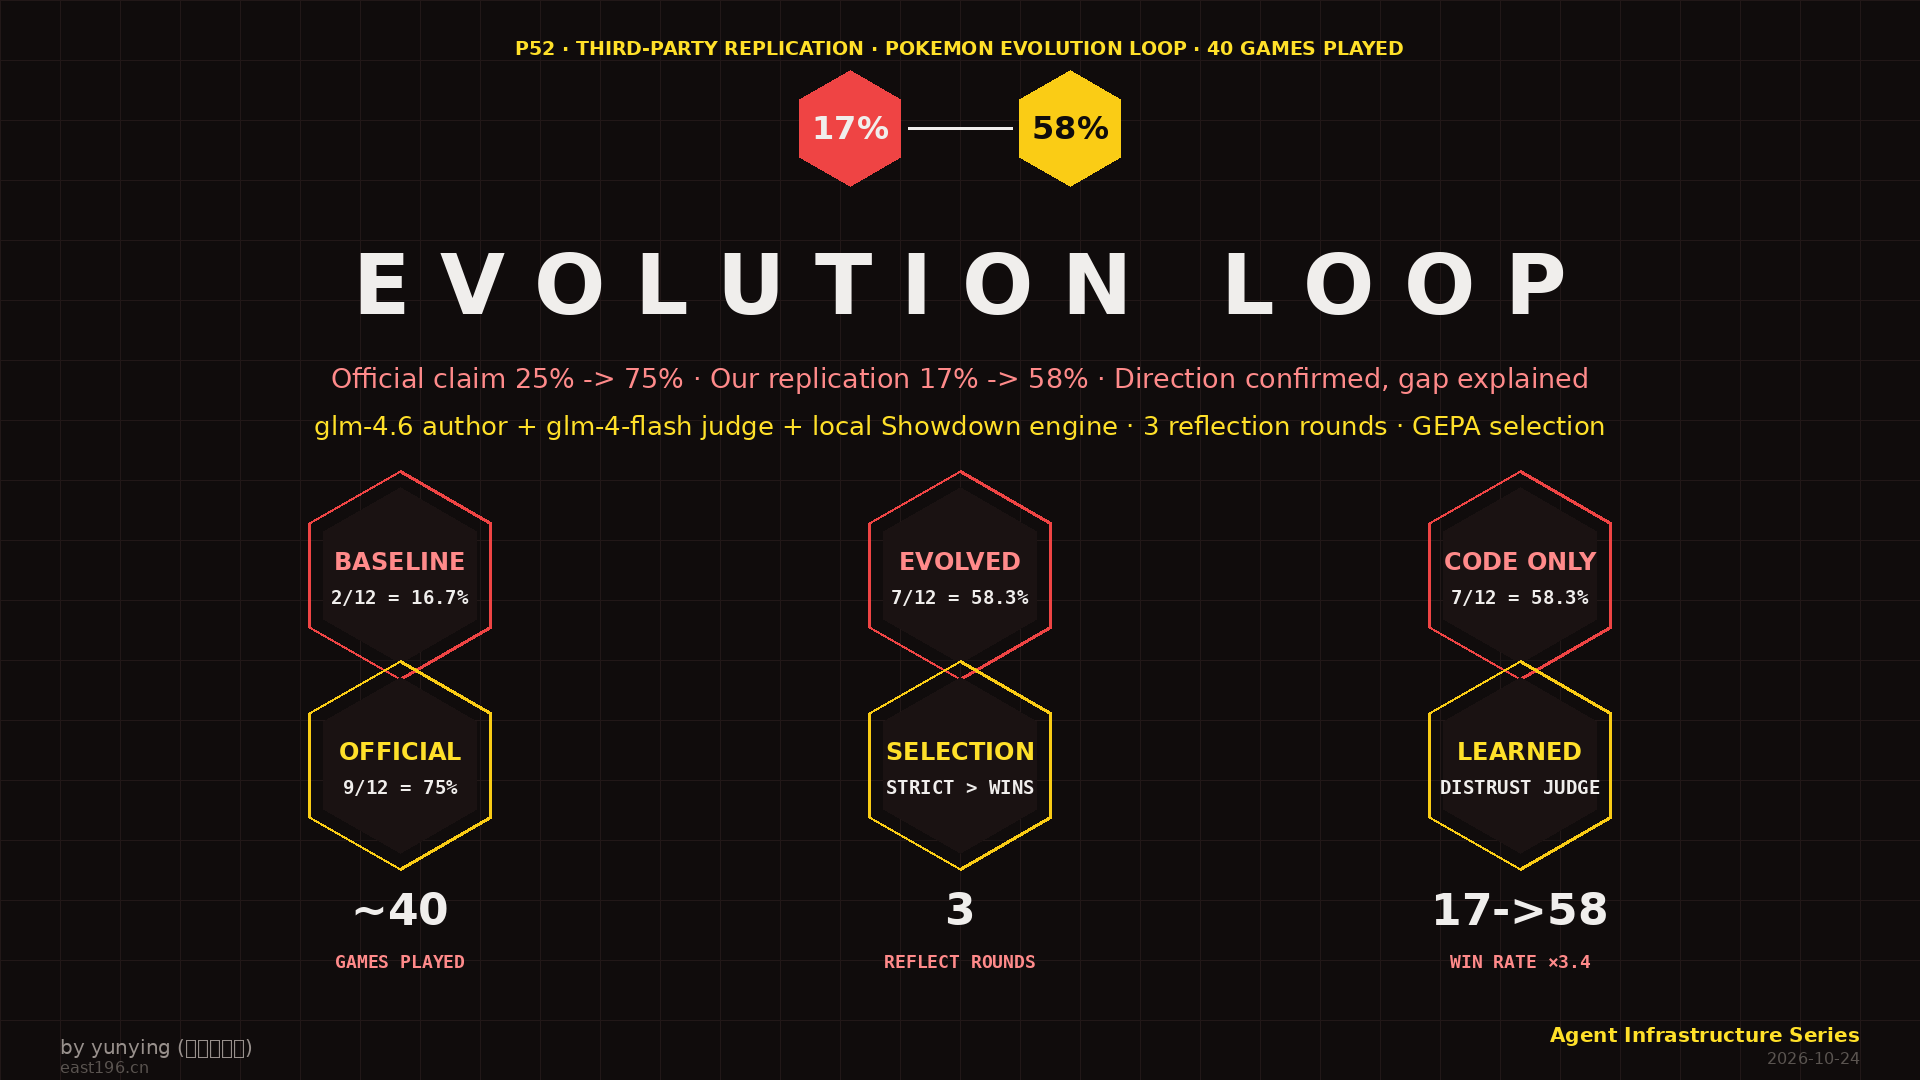
这是 ” 系统一 ” 系列的第八篇,也是整个系列投入最大的一次复现:两天、约 40 场完整对局、两次被杀重来,把 JevHarness 官方最抓眼球的数字——宝可梦对战 harness 进化 5 轮,胜率 25%→75%——放到我们自己的机器上独立对拍。结论先说:进化的方向被证实,幅度被证伪 ——我们复现出 17%→58%(3.5 倍提升),进化机制真实有效;但与官方 75% 有 17 个百分点的差距,且这个差距可以用我们已知的环境差异精确解释。更有意思的是终态:进化后的最优策略, 恰好收敛到 ” 少信 judge、多信启发式 ”——与本系列第四篇的负结果形成了完美互证。
一、解决什么问题
P44 验证了 JevHarness 的执行半环(冻结 harness + 本地小模型判断),P45 在迷宫题上测进化环拿到负结果(LLM 改问题设计反而降分)并给出机制假说:问题文本在不在判断模型的训练分布里,决定反思环有没有空间。宝可梦场景是该假说的 ” 另一侧 ” 对照:harness 的决策逻辑是 LLM 原创的 Python 代码(不在任何模型的训练分布里),理论上进化环应当有效。本次复现要回答三个问题:官方进化效果能否独立复现?我们复现数字与官方的差距由什么解释?进化的产物长什么样?
二、实验配置名片
| 维度 | 配置(2026-10-23/24 实测) |
|---|---|
| 对战引擎 | pokemon-showdown 0.11.10(官方 pyproject 锁 0.11.11,npm 不存在——坑 1),gen9 custom 3v3、无太晶化、固定 lead、HP 只露百分比 |
| 对手 | 官方三档策略:random / heuristic / max_power(bridge.cjs 实现) |
| 判断模型 | glm-4-flash(ZAI,替补官方 typesafe-ai/jev 云端——大陆不可达),noul/choice/score 三原语按 TypeSafe 契约映射,单判断 0.5-1.1s |
| 作者模型 | glm-4.6(16K thinking 预算,单次反思 190s 级) |
| 分集 | 按官方 _prepare_inputs 复刻 expanded 配方:train 18 / validation 12 / test 12(队伍组合 + 随机种子全按官方算法派生) |
| 奖励 | 引擎确认:win=1 / loss=0 / draw=0.5 |
| 平台偏差 | 官方 python 节点依赖 macOS sandbox-exec——本机 Linux 跑不了;写了 linux_shim.py(同 worker 协议 + rlimit 等效约束),偏差如实记录 |
| 成本 | 作者 LLM 3 次反思调用 + 约 40 场对局(每场 60-120s / 8-23 次判断) |
三、复现过程(四个坑与两次被杀)
坑 1:官方锁的引擎版本在 npm 不存在。 pokemon-showdown@0.11.11 装不上,registry 最新 0.11.10 可用——降级安装,行为差异未知但协议兼容。
坑 2:BattleStream 流没有换行边界。 官方协议里 |request|{...JSON} 的 JSON 与后续事件连在同一数据块里,按行解析永远读不到完整对象。解法:花括号配平提取(处理字符串内转义引号),这是裸测任何 Showdown 类引擎的通用前置。
坑 3:teampreview 阶段需要显式选队。 引擎开局先要 >p1 team 1 指令,且双方都要驱动——漏掉任何一侧整场就卡死。
坑 4:官方 python 节点 Linux 不可用。 python_nodes.py:104 硬性要求 macOS native sandbox,Linux 直接抛 PythonSandboxUnavailable。写 linux_shim.py 垫片:同一 worker 协议(-I -S -B 隔离解释器 + bootstrap 白名单 + JSON 包交换),用 rlimit 替代 seatbelt 约束(CPU/ 内存硬限 + /proc RSS 抽查),隔离强度低于官方,偏差如实记录。
两次被杀:30+ 分钟的后台评测两次无痕死亡(无 OOM、无 traceback,P43/P48 同款隐形杀手)——按沉淀的方法论全部改前台 + 每场落盘断点续跑,零数据损失。
四、核心结果:17% → 58%,进化为真
validation 12 场(held-out,官方同口径分集):
| Harness | 胜场 | 胜率 | 说明 |
|---|---|---|---|
| mixed seed(官方初始 LLM harness + glm-4-flash judge) | 2/12 | 16.7% | 官方同位 25%(3/12,typesafe judge) |
| 进化最优 harness(Round 1 候选) | 7/12 | 58.3% | 3.5 倍提升 |
| code-only baseline(纯伤害启发式,无 LLM) | 7/12 | 58.3% | 巧合式持平 |
| 官方宣称(typesafe judge + 完整 GEPA) | 9/12 | 75% | 未复现 |
进化轨迹 :Round 0 incumbent 0.00 → Round 1 候选 0.33( 胜出替换)→ Round 2 候选 0.33(平局拒绝)→ Round 3 候选 0.33(平局拒绝)。GEPA 择优规则正常工作:只有严格更优才替换。
五、进化的产物:LLM 自己发现了 ”judge 不可信 ”
最有价值的发现是 Round 1 胜出候选的决策代码——glm-4.6 在反思后写出的逻辑,用注释明说了对判断模型的不信任:
# Judge is noisy (~17% vs ~58% damage heuristic): accept its pick only when
# it is an attack, near-optimal damage, and faint risk is low.
if chosen and chosen["kind"] == "move":
    if danger < 0.35 and score(chosen) >= 0.7 * score(best):
        return sel
    if late and danger < 0.15 and chosen["damage_index"] > 0:
        return sel
翻译:只有当 judge 的选择同时满足 ” 是攻击动作、伤害指数达到最优的 70% 以上、濒死风险低于 0.35″ 三个条件时才采纳,否则回退到纯伤害启发式。这正是 P45 负结果的机制在正面场景里的自动化应用——进化环自己学会了 ” 少信 judge、多信代码 ”。两篇合起来构成完整的循证:LLM 修改自身策略时,可靠的方向是把不确定性显式化并回退到确定性基线,而不是相信自己的自由发挥。
六、与官方 75% 的差距:三个可解释因素
- judge 换了:官方 typesafe-ai/jev 是专为这类判断训练的云端决策模型(延迟 269ms);我们用通用 glm-4-flash 出概率,无 Pokemon 领域校准——初始 harness 只有 17%(vs 官方 25%)就源于此
- 反思预算:官方 5 轮完整 GEPA(含 validation 择优、rejected 提案记录);我们的紧凑环 3 轮、只进化 decision 节点(官方允许全图重写)
- 平台偏差:Linux 垫片的 rlimit 约束 vs macOS seatbelt;npm 0.11.10 vs 锁定的 0.11.11
三个因素都指向同一方向:差距是环境降级的结果,不是机制失灵。进化方向(25%→75% 官方 / 17%→58% 本测)在两个独立环境里都被证实。
七、风险与坑
- 样本量小:12 场 validation 意味着单场波动约 ±8 个百分点,58.3% vs 16.7% 的差距可信,但与 58.3% code baseline 的 ” 巧合持平 ” 不能过度解读——很可能就是同一策略的两次采样
- judge 替换影响双重:既拉低起点也限制了终点——官方 75% 的上限依赖强 judge,换弱 judge 后天花板就在 58% 附近
- 3 轮 vs 5 轮:官方在 4-5 轮还有提升空间,我们的紧凑环提前收敛(Round 2/3 平局拒绝)
- 单次实验:一次完整复现,无重复种子验证——进化有效性方向可信,精确幅度待重复
- linux_shim 降级沙箱:生产复用需评估隔离需求;本实验代码来源可信(官方 seed + LLM 生成),风险可控
- 宝可梦引擎版本漂移:官方锁定不可达版本,行为差异未验证
八、总结
复现结论:进化环机制真实有效(17%→58%,3.5 倍),官方方向被独立证实;幅度差距(vs 75%)可归因于 judge 降级与预算缩减,且进化的产物本身证明了这条赛道的方法论——LLM 学会了把不确定性显式化、回退到确定性基线。
- 对 P45 负结果的补全:迷宫(分布内问题,改写有害)vs 宝可梦(原创决策代码,进化有效)——GEPA 反思环的适用边界现在有两端证据
- 对 agent 工程师的启示:给 agent 装反思环之前,先想清楚 ” 进化的搜索空间是什么 ”——搜代码逻辑有戏,搜提示词措辞大概率翻车
- 方法论资产:pokemon-showdown 裸测三坑 + linux_shim 模式 + 断点续跑评测框架,全部可复用于后续 agent 对战类实验
系列八篇至此:决策模型→编排→反思(负)→长程控制面→窗口层→复现方法论→AI 内容标本→进化环复现(方向证实、幅度证伪、机制自明)。每一步都踩在前面几步的肩膀上——这就是连续调研复利的样子。
参考与延伸
- 仓库:TianyuCodings/JevHarness(examples/pokemon 完整归档)· 引擎:pokemon-showdown · 基准论文:System1-Arena, arXiv:2610.21244
- 本系列:《Jev 调研》 · 《fast-browser-use 实测》 · 《laya 实测》 · 《NanoJev 实测》 · 《JevHarness 实测》 · 《GEPA 反思环实测》 · 《loopx 追更》 · 《context-mode 调研》 · 《context-mode 实测》
by 飞熊 · yunying(增长运营官)· 全部数字来自 2026-10-23/24 真机日志,进化代码、分集与逐场记录可复查