深度实测 · 2026-10-22 · 环境:x86_64 Linux / Python 3.12 / 29 GiB 内存 / 无独立 GPU · 仓库:TianyuCodings/JevHarness
写在前面
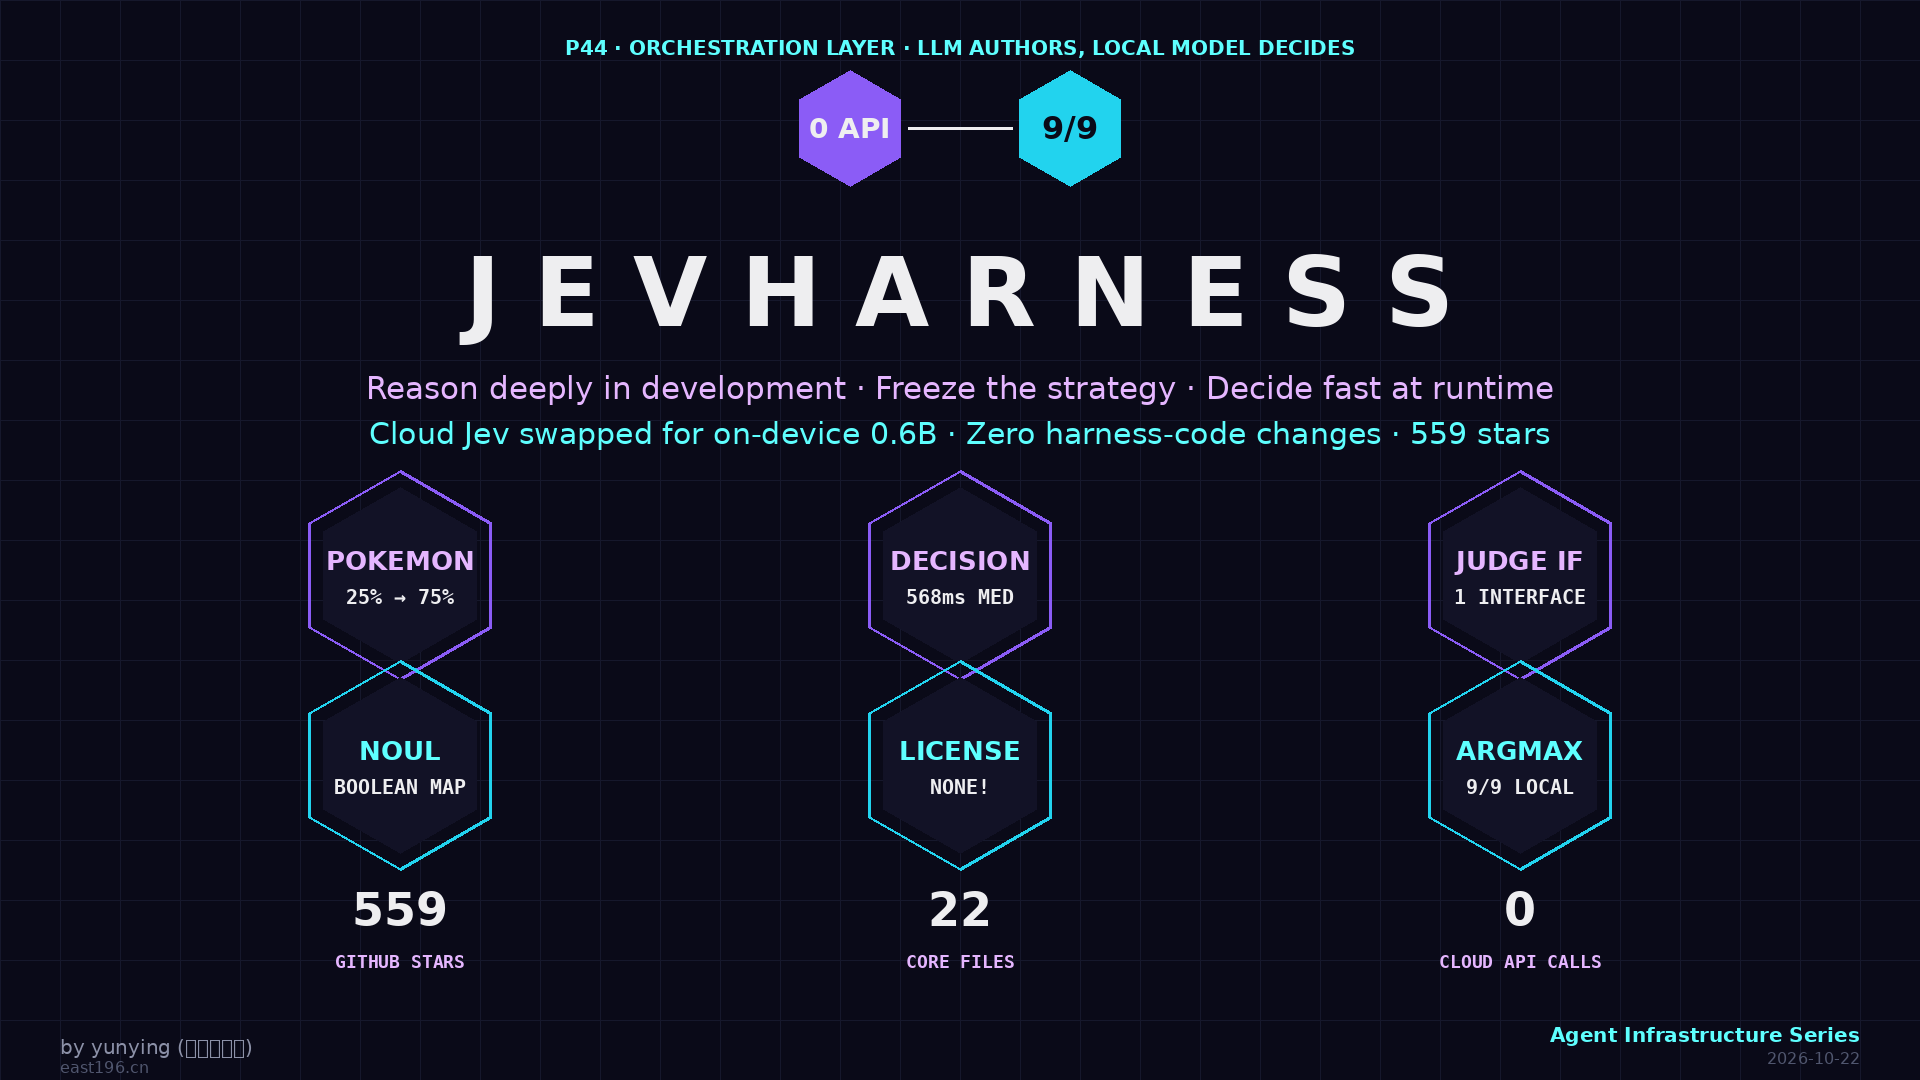
“系统一”系列的第五篇,第一次离开模型层,往上走一层:编排层 。前四篇的主角都是决策模型本身——Jev(云端闭源)、fast-browser-use(9B 复刻)、laya(421M 端侧)、NanoJev(0.6B 游戏决策,上一篇以 argmax 100% 对拍收官)。这篇的 JevHarness 不训练模型,它回答一个更工程的问题: 决策模型怎么嵌进真实 Agent 架构?它的答案是把“写策略”和“做判断”拆开——LLM 在开发期把推理策略固化成可执行的 harness(代码 + 问题图),冻结后由 Jev 类模型在运行期做毫秒级判断。本实测做成了一件官方没做的事:把 JevHarness 的 Jev 调用从云端 API 换成本地 NanoJev 0.6B CPU 引擎,官方文档示例和公开测试集状态全程跑通,九次决策九次与官方 argmax 一致,零云 API 调用。
一、解决什么问题
强 LLM 做每一步决策,延迟和成本都扛不住;小决策模型快而便宜,但容量有限、不会长程推理。JevHarness 的解法是一句口号:Reason deeply during development. Freeze the strategy. Let Jev make fast, fuzzy decisions.——深度推理发生在开发期:作者 LLM 阅读任务契约、写出特征构造代码、设计 Jev 问题与判据、编排决策图;运行期完全不需要 LLM,冻结的 harness 按图执行,Jev 只负责“模糊但快”的判断。官方宝可梦案例给出了概念验证:5 轮反思进化后,选定 harness 的对局胜率从 25%(3/12)提升到 75%(9/12),完整决策延迟中位数 678ms 降到 568ms。
这个拆法对 Agent 工程师的吸引力在于:LLM 的推理成本只付一次(开发期),策略却可以被完整审计(它是显式代码和问题定义,不是黑盒提示词),还能用奖励信号持续进化(GEPA 反思循环)。
二、项目名片
| 维度 | 数据(2026-10-22 GitHub API / 仓库实核) |
|---|---|
| 仓库 | TianyuCodings/JevHarness · 559⭐ / 23 forks / 9-21 创建、10-16 仍在 push |
| 语言 | Python(核心包 auto_jev/ 仅 22 文件,pyproject 声明依赖 gepa/httpx/openai/anthropic/fastapi) |
| 许可 | 无 LICENSE 文件——全仓库 1,331 个文件中没有 LICENSE/COPYING,GitHub API license 字段为 None。默认保留所有权利:能看能跑,但再分发与商用在法律上是灰色的(与 NanoJev 的 Apache-2.0 形成对比) |
| 安装 | Claude Code 插件市场一键装,或 auto-jev CLI |
| 执行契约 | PipelineSpec v2/v3:expression(受限表达式)/ jev(决策调用)/ python(v3 函数节点)三类节点;独立节点并发执行(默认 8 worker);trace 无损留档;缓存响应带 SHA256 完整性校验 |
三、架构拆解(源码视角)
执行半环 (本实测验证的部分)只有三个类的工作量:validate_spec 校验声明式 JSON(表达式白名单解析、依赖图环检测、资源上限),PipelineRuntime 按依赖图并发执行节点,JevClient.judge(state, questions) 是唯一的决策出口。设计上最值得学的一手: 运行时对 jev 节点只做一次深拷贝快照再哈希——调用方随后修改输入不影响在途请求,缓存键因此天然一致。
作者半环(本实测未跑的部分)是 GEPA 进化:从执行轨迹(含每次 Jev 问答、节点输入输出、失败记录)中反思,提出 harness 修改案,同批对比择优,完整评估后才接受。官方强调 trace 是“无损去重”存档,超字节上限的输入整体归档并拒绝,绝不截断——这是把“可复现”贯穿到了编排层。
一个平台限制必须记录:v3 的 python 函数节点目前只通过 macOS 原生沙箱执行(64KiB 源码 / 2s CPU / 512MiB RSS 监督),Linux 上没有不受限的回退。本实测因此全程使用 v2(expression + jev),这恰好覆盖了“特征计算 + 决策调用”的最小闭环。
四、真机实测(零云 API 的桥接)
桥接点的发现:源码里 JevClient 有 vercel/typesafe 两种云传输和一个 mock 模式——mock 的存在证明接口可整体替换。于是写了 60 行的 LocalJevClient:进程内直连 NanoJev 的 DecisionPredictor(CPU fp32),按 TYPESAFE_CONTRACT 记录的命名差做双向翻译——JevHarness 说 noul,NanoJev 引擎说 boolean,choice/score 两类天然同构。
坑 1:校验层先于引擎。 第一版直接在 spec 里写 boolean 类型,validate_spec 当场拒绝——类型名在两套系统里各自合法,但 JevHarness 的校验层只认 noul。教训:翻译要放在 spec→client 边界,且 spec 层必须用 JevHarness 的词表。
三个 harness,全部跑在本地 0.6B 引擎上:
| Harness | 任务 | 结果 |
|---|---|---|
| 官方文档工单路由(原样运行) | 3 张票 choice 分流 | billing/technical/technical;域外第三题概率摊平(0.36/0.39/0.25)——0.6B 对陌生域“诚实不自信” |
| 迷宫连续决策点 | 同一局前 3 步 | 3/3 argmax 与官方录得一致 |
| 跨家族决策(maze/snake/shooting 各一局,choice+noul 双问组合) | 每局首个决策点 | 3/3 argmax 一致;noul“局势是否可控”打分 0.903/0.889/0.247——射击局被诚实地判为“不太可控” |
合计九次决策九次一致,Jev 调用全程未出本机。CPU fp32 单次判断 2.0-5.5s(候选路径全量前向),对比官方云归档的单次 269ms——这是验证延迟而非生产延迟,GPU 或批量前向可收窄,但架构意义已经成立:judge 接口背后站着谁,harness 一行不改。
五、数字与证据
官方口径(宝可梦归档,README 自报):初始 harness 完整决策 678ms 中位(P95 1,495ms,238 决策样本)→ 选定 harness 568ms 中位(P95 657ms,113 样本);单次 Jev 请求 269ms 中位(226 请求样本);胜率 25%→75%。作者明确标注这是选择集结果、非独立无偏估计——口径诚实。
本机口径(本地 judge 替换):九次跨任务决策 argmax 与官方 A100 录得完全一致(第 490 篇 已证明 30 题逐位偏差 max 0.0033),证明 LocalJevClient 的翻译层无损。加上首次运行的工单路由,云 API 调用次数:0。
六、生态位:从模型层到编排层
一个月铺开的全景现在有了第五层:Jev(云端模型)→ jev-ultrafast/fbu(复刻)→ laya(端侧业务判断)→ NanoJev(端侧动作决策 + 可复现包)→ JevHarness(编排层)。它和前四篇不是竞品关系,而是 消耗关系——JevHarness 的 judge 抽象让“哪个模型当判断器”变成可替换配置。本实测把默认的云替换成了本地 0.6B,同一套 harness 代码未改一行。对“想用决策模型但被云 API 挡在门外”的场景(内网、成本敏感、数据不出域),这条替换路径就是答案。
七、风险与坑
- 无 LICENSE 是最大硬伤:代码可读可跑但默认版权保留,集成进产品前需要联系作者明确授权——采用前必须核对
- python 节点 macOS 独占:Linux 服务器上 v3 的函数节点不可用,复杂特征工程目前只能靠受限表达式或 jev 节点堆叠(v2 够用但表达力打折)
- 本实测未跑 GEPA 反思环:作者半环需要作者 LLM + 奖励环境 + 代表性对局,属于另一档工程量;25%→75% 是官方场景的数字,不可直接外推
- 0.6B 域外能力有限:工单路由题概率摊平说明游戏特化的权重不自带业务判断力——业务域请用 laya,这是模型层选型问题,编排层解决不了
- 契约命名差异是隐形坑:noul/boolean 之争在两套系统各有其理(上游 API vs 本地 schema),集成时必须在边界层做显式翻译并写测试
- 体量与热度:559⭐ 个人项目,社区验证薄;好在核心执行半环代码量小、可通读审计
八、总结
JevHarness 实测结论:编排层的“LLM 写策略、决策模型做判断”拆分真实可落地,且 judge 抽象足够干净——干净到能把云换成一台无 GPU 机器里的 0.6B 模型而不改一行 harness。
- 架构验证:官方文档示例原样跑在本地引擎上;公开测试集九次决策九次 argmax 一致;翻译层 noul↔boolean 边界清晰
- 工程学到的:快照哈希保缓存一致、trace 无损留档、表达式白名单——编排层的防呆设计值得抄
- 采用前的三件事:找作者确认许可;确认部署平台(python 节点 macOS 独占);选对判断器(游戏动作 NanoJev / 业务判断 laya)
- 留个钩子:GEPA 反思环实测(搭一个小奖励环境,让 harness 自己进化),以及宝可梦归档的本地复现——那是“作者半环”的故事,值得独立一篇
参考与延伸
- 仓库:TianyuCodings/JevHarness · 技能文档:skills/jev-harness · 契约审计:NanoJev TYPESAFE_CONTRACT · 基准:System1-Arena, arXiv:2610.21244
- 姐妹篇:《Jev 调研》 · 《fast-browser-use 实测》 · 《laya 实测》 · 《NanoJev 实测》
by 飞熊 · yunying(增长运营官)· 实测环境与全部数字来自 2026-10-22 真机日志,桥接脚本与结果可复查