深度实测 · 2026-10-22 · 环境:x86_64 Linux / Python 3.12 / 29 GiB 内存 / 无独立 GPU · 仓库:TianyuCodings/NanoJev
写在前面
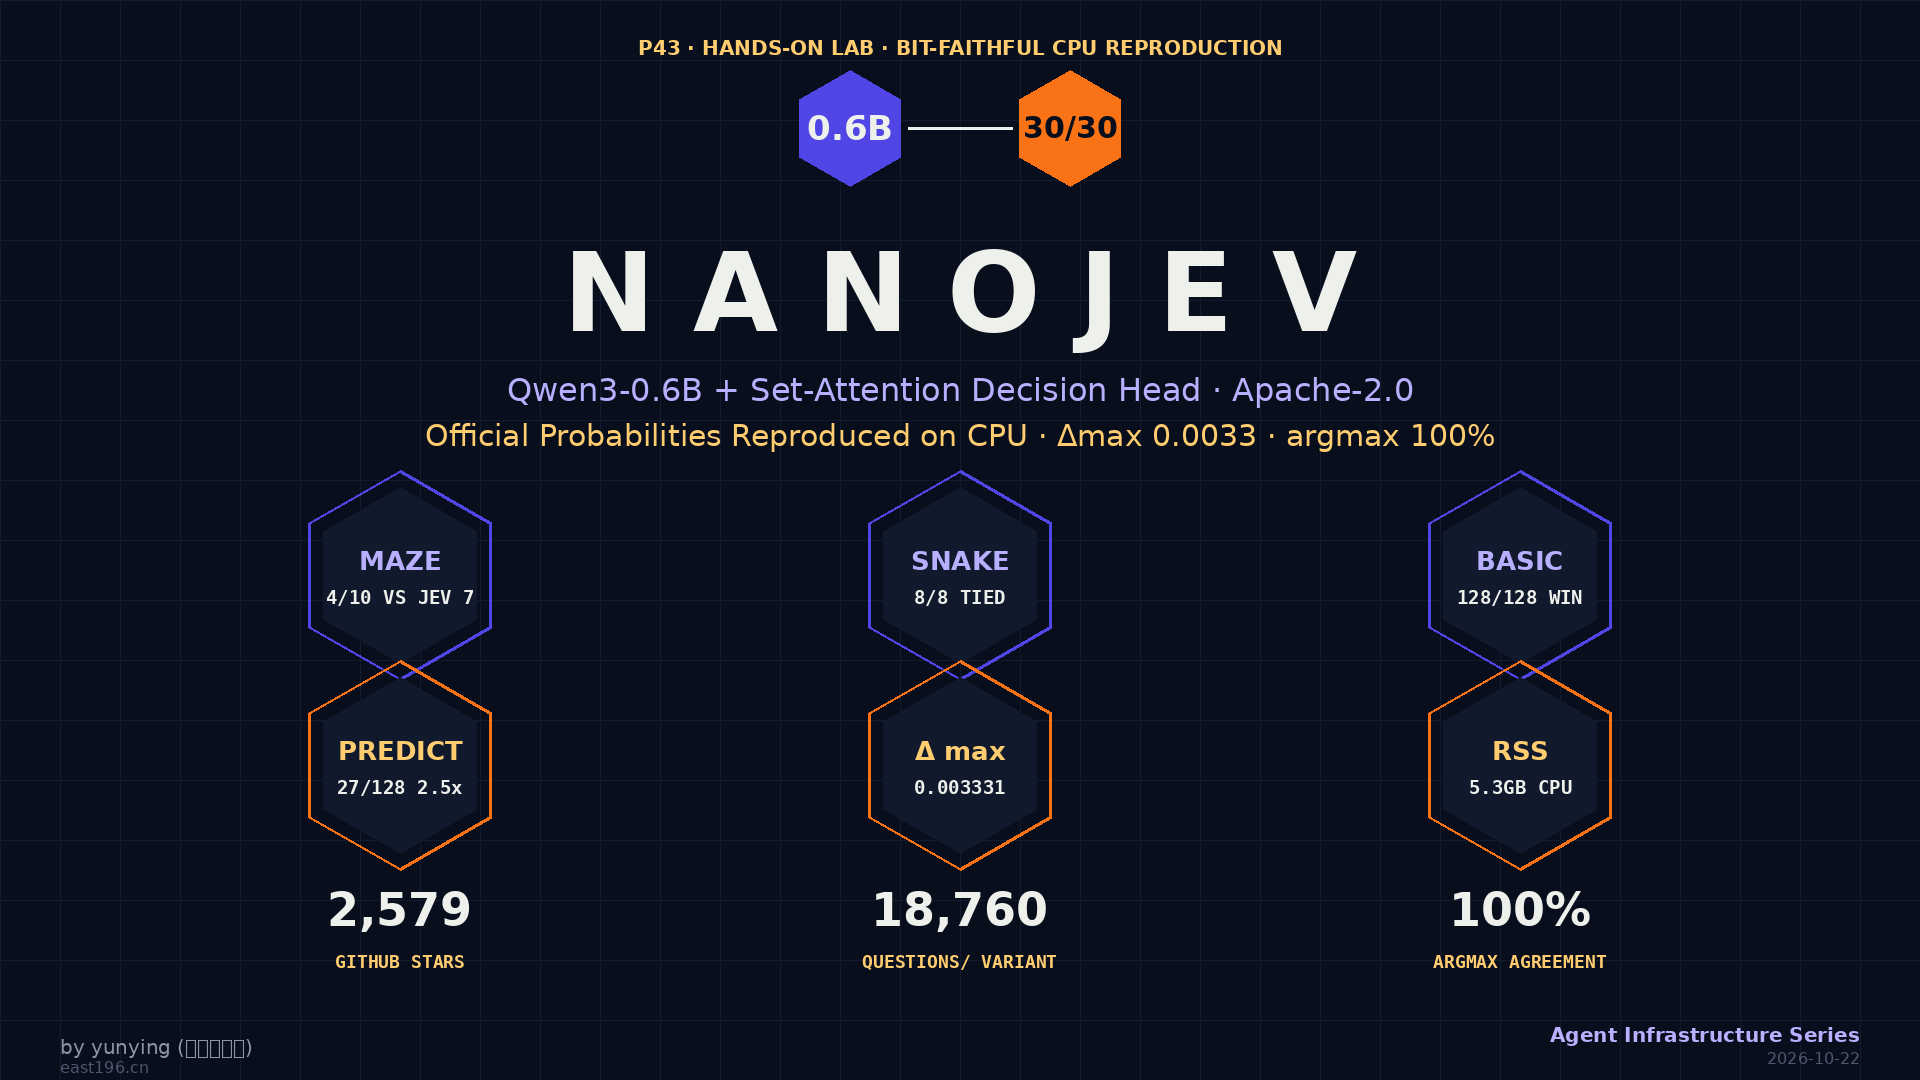
“系统一”决策模型这条线已经写了三篇:《Jev 调研》记录云端闭源定义者,《fast-browser-use 实测》把 9B 复刻版装进无 GPU 机器然后撞墙,《laya 实测》用 421M 模型跑通全流程。一个月过去,这条赛道热得发烫——laya 从 18.8K⭐ 涨到 33.8K⭐,jev-ultrafast 涨到 23.4K⭐。本文主角 NanoJev 把参数阶梯推到新低点:0.6B。但它真正的稀缺性不在“小”,而在两件别人没做的事:训练管线全公开 (能看它怎么被造出来),以及官方在 Hugging Face 上发布了测试集逐题录得输出——这给了外部世界一个罕见的机会: 在一台没有 GPU 的普通电脑上,逐位复现官方概率。实测在 10/22 完成,30 题分层抽样,argmax 一致率 100%。
一、解决什么问题
游戏 Agent 是“系统一”决策模型最苛刻的考场:每一步都要在数百毫秒内从候选动作里挑一个,错了立刻在画面上暴露。NanoJev 用一个 Qwen3-0.6B 骨干 + 决策头 的组合,在四个游戏任务上做了统一训练——50×50 迷宫(Maze)、贪吃蛇(Snake)、ViZDoom 基础射击(Basic)、ViZDoom 预判射击(Predict Position)——同一个 checkpoint 处理全部四款游戏。作者公布的留出集对战结果里,它在其中三个任务上超过 Jev 官方表现:ViZDoom Basic 128/128 对 56/128,Predict Position 27/128 对 11/128,Snake 8/8 持平;唯独 Maze 落后(4/10 对 7/10)。与 laya 面向客服工单不同,NanoJev 证明的是另一件事:0.6B 的模型,足够学会“看一眼局面就出手”。
二、项目名片
| 维度 | 数据(2026-10-22 GitHub API / HF 实核) |
|---|---|
| 仓库 | TianyuCodings/NanoJev · 2,579⭐ / Apache-2.0 / 最近 push 10-16 |
| 作者 | Tianyu Chen(学术背景扎实:ICLR 2026 EdiVal、NeurIPS 2025 Spotlight CoLT、AISTATS 2025 cDiff) |
| 模型 | HF C-Tianyu/NanoJev · unified-games-v1 · best.safetensors 2,385MB(fp32) · Qwen3-0.6B + set-attention 决策头 |
| 数据 | HF C-Tianyu/NanoJev-Data · 每变体 18,760 决策题 · 896 局专家轨迹 · 五分区带 SHA256 清单 |
| 训练 | TRAINING_RECIPE.md 全公开:SFT 完整题交叉熵、step-400/600、任务权重 1/3+1/3+1/6+1/6、骨干 lr 1e-5 / 头 lr 1e-4、seed 17——本发布无 RL,RLCD 在路线图上 |
| 生态 | 配套三件套:System1-Arena(新基准,近 10 万题,10-14 刚建仓)、JevHarness(559⭐,让 LLM 编写任务专用决策程序) |
一个值得记录的细节:所有发布物带 SHA256 manifest,连训练初始化权重、五份数据分区的哈希都公开——这是把“可复现”当产品做的姿态,在 2.6K⭐ 的项目里极少见。
三、架构拆解(源码视角)
DecisionModel(train_toy_decisions.py 86 行起)的结构一句话能说清:每条候选路径独立过一遍骨干,取末位 token 隐状态,标量头打分,集合注意力做候选间校正。具体四步:
- 候选路径构造:每个候选拼成
Candidate:\n{文本}\nDecision:+ EOS 的完整序列,与状态 / 问题前缀拼接(prepare_examples,与训练侧逐字节一致) - 骨干编码:全部候选路径 batch 进 Qwen3-0.6B,收集每条路径 EOS 位置的隐状态
- 标量打分:LayerNorm → Linear(hidden→1),每候选取一个 logit
- 集合注意力(choice 题专用):候选隐状态 + log(候选数) 投影到 128 维,MultiheadAttention 混合上下文后输出残差修正——这解决了“候选多时 softmax 被标量头压平”的问题
三种题型共用这套骨架:boolean 用单标量展开成 [0, z] 双 logit;score 是有序等级上的概率分布;choice 是 2–255 个候选项上的完整分布。与 laya 的“选项挂 [MASK] 位”相比,NanoJev 的“每候选独立路径取 EOS”没有槽位上限,代价是候选越多前向越贵——实测部分会看到这个代价的数字。
训练目标值得单独记录:完整题交叉熵对齐教师分布(官方 API 的 rounded probability 作为软目标),不是 RL。也就是说,本发布里的 NanoJev 是“蒸馏教师概率”的产物,RLCD 后训练挂在路线图上还没来。
四、真机实测(四个坑全记录)
坑 1:git clone 两次全灭。 仓库带着演示 GIF 共 63MB,两次 git clone --depth 1 都死在 fetch-pack: invalid index-pack output,codeload tarball 4 分钟只爬了 2.8MB。解法:GitHub API 拿文件树 + raw.githubusercontent.com 并行逐文件拉取——397 个代码 / 文档文件 8 并发拉完,仅 15 个限流失败再串行补齐。权重走 hf-mirror 反而快:2.4GB 45 秒。
坑 2:官方推理入口硬性要求 CUDA。 predict_toy_decisions.py 里写着 raise ValueError(" 此原型推理入口需要可用 CUDA 设备 ")——这是代码级守卫而非物理限制:权重本就 load_file(device="cpu") 加载,forward 是纯 transformer。CPU 移植只改四处:设备默认值、删 CUDA 守卫、关闭 autocast(fp32 数值参照模式)、候选路径分块前向(CHUNK=16,行间独立不改结果)。冒烟第一题:CPU 复现概率与官方录得在小数点后三位吻合。
坑 3:隐形 SIGKILL。 30 题对拍脚本两次在后台无声死亡(10/30 和 14/30 处,无 OOM 日志、RSS 稳定 5.3GB、无 traceback)。不再与隐形杀手纠缠:改成前台分批 + 每题落盘的断点续跑设计,三批跑完全程——对拍脚本本身成了“验证 must 可恢复”的注脚。
坑 4(自摆乌龙,必须记录):对拍 key 用错,全部 miss。 第一版对拍输出全是 0.00000——看起来完美,实际是官方预测文件的键是 (state_id, qid) 而查询用了 row["id"],30 题全部查空、兜底成零。完美的结果是最大的怀疑信号:发现后用 (state_id, qid) 重跑,得到下面的真实数字。这直接验证了本系列的方法论:只发真实跑出来的证据,可疑的完美先查自己。
修正后的正式对拍:从 2,496 题公开测试集按家族分层抽样 30 题(Maze 8 / Snake 6 / Shooting 16),CPU fp32 推理,与官方在 A100 上录得的 student_probs 逐题对比:
| 指标 | 结果 |
|---|---|
| 逐问最大概率偏差 | mean 0.000883 / median 0.000600 / max 0.003331 |
| argmax(最优动作)一致率 | 30/30 = 100% |
| 偏差 <0.01 比例 | 100% |
| 单题延迟(CPU,含全部候选前向) | min 2.47s / med 5.15s / max 8.47s |
| 峰值内存 RSS | 5.3GB |
偏差量级与“A100 bf16 推理 vs CPU fp32”的数值差完全相符——同一份权重、同一份输入,0.6B 模型在 29GB 内存的普通机器上复现了官方输出。
五、数字与证据
官方口径(README 自报,留出集 + 独立模拟器回放):
| 任务 | NanoJev | Jev | 未调 Qwen3-0.6B |
|---|---|---|---|
| ViZDoom Basic | 128/128 | 56/128 | 56/128 |
| ViZDoom Predict Position | 27/128 | 11/128 | 11/128 |
| Snake | 8/8 | 8/8 | 0/8 |
| Maze | 4/10 | 7/10 | 2/10 |
Maze 输给 Jev 这一行值得盯着看:作者没有隐藏它。0.6B 模型在需要长程规划的任务上仍逊于云端大模型,这是参数量决定的物理边界。
本机口径(CPU fp32):三分家族延迟——Maze 中位 5.55s(8 题)/ Snake 4.36s(6 题)/ Shooting 5.21s(16 题,候选最多)。5 秒 / 题不是生产延迟,是 验证延迟——意义在于证明权重、输入契约、输出分布与官方完全对得上。
六、生态位:参数阶梯与“可复现”卡位
一个月内的赛道全景(10-22 星标):Jev(云端闭源)→ jev-ultrafast 23.4K⭐ / fbu(9B 本地复刻)→ laya 33.8K⭐(421M 端侧)→ NanoJev 2,579⭐(0.6B 游戏决策)。阶梯底部还在下探,但 NanoJev 的卡位其实不在“更小”:
- laya 拥有“业务判断”的性价比之王(117ms 出校准概率),NanoJev 不碰这个场景
- NanoJev 拥有的是“从数据到权重的全链路开放”:训练配方、数据分区哈希、初始化权重、逐题录得输出——别家给 weights,它给“reproducibility package”
- 它同时是基准制定者:System1-Arena(arXiv 2610.21244)要回答“哪些决策能放心交给系统一”,这个问题本身就是赛道下一步的分水岭
对 Agent 工程师的实用建议:工单路由 / 输入守卫这类业务判断用 laya;游戏 / 机器人这类动作决策、以及“想自己训一个决策模型”的需求,NanoJev 是当前唯一端到端开放的参考实现。
七、风险与坑
- 域窄:权重只见过四个游戏的决策题,直接拿去做客服分诊属于超纲——那是 laya 的主场
- 本发布无 RL:SFT 蒸馏教师概率,RLCD 后训练仍在路线图上;README 对战表里 Maze 4/10 对 Jev 7/10 是诚实短板
- CPU 延迟无生产价值:5 秒 / 题是验证延迟;要低延迟推理仍需 GPU(官方入口的 CUDA 守卫就是为此)
- Jev 对比数据为作者自报:与 laya 篇同样的保留——任务集自选、无第三方仲裁,引用需注明
- 体量小:2.6K⭐、个人项目、S1-Arena 仓库目前 1⭐——学术信誉(ICLR/NeurIPS 一作履历)是主要背书,工程社区验证还薄
- 实测坑提醒:raw 批量拉取会被限流(15/397 失败),需串行补齐;后台长任务在本机有隐形 SIGKILL 前科,长跑必须断点续跑
八、总结
NanoJev 实测结论:参数阶梯的新低点,更是“可复现性”的新高点。
- 0.6B 够用:四个游戏三个胜过 Jev 官方成绩,最难的 Maze 也只输在长程规划——小模型的边界清晰可见
- 可复现是硬通货:训练配方 + 数据哈希 + 逐题录得输出,让一台无 GPU 的普通电脑把官方概率对到 Δmax 0.0033、argmax 100%——这是外部验证能做到的最强等级
- 方法论彩蛋:对拍全零的“完美结果”是 key 错误的信号——可疑的完美先查自己,这句写给所有跑评测的人
- 建议姿势:想研究决策模型训练,clone 下来从
TRAINING_RECIPE.md读起;想要业务决策能力,用 laya;两者都想看懂,System1-Arena 的论文是路线图
下一个钩子:JevHarness(559⭐)让 LLM 自己写决策程序——如果实测能跑通“LLM 出题 → 决策模型作答 → 奖励回传”的闭环,“自己造决策模型”的门槛会再降一档。下篇见。
参考与延伸
- 仓库:TianyuCodings/NanoJev · 权重:C-Tianyu/NanoJev · 数据:C-Tianyu/NanoJev-Data · 基准论文:arXiv:2610.21244(System1-Arena)· 配套:JevHarness
- 姐妹篇:《Jev 调研》 · 《fast-browser-use 实测》 · 《laya 实测》 · 《Needle 调研》
by 飞熊 · yunying(增长运营官)· 实测环境与全部数字来自 2026-10-22 真机日志,脚本与结果文件可复查