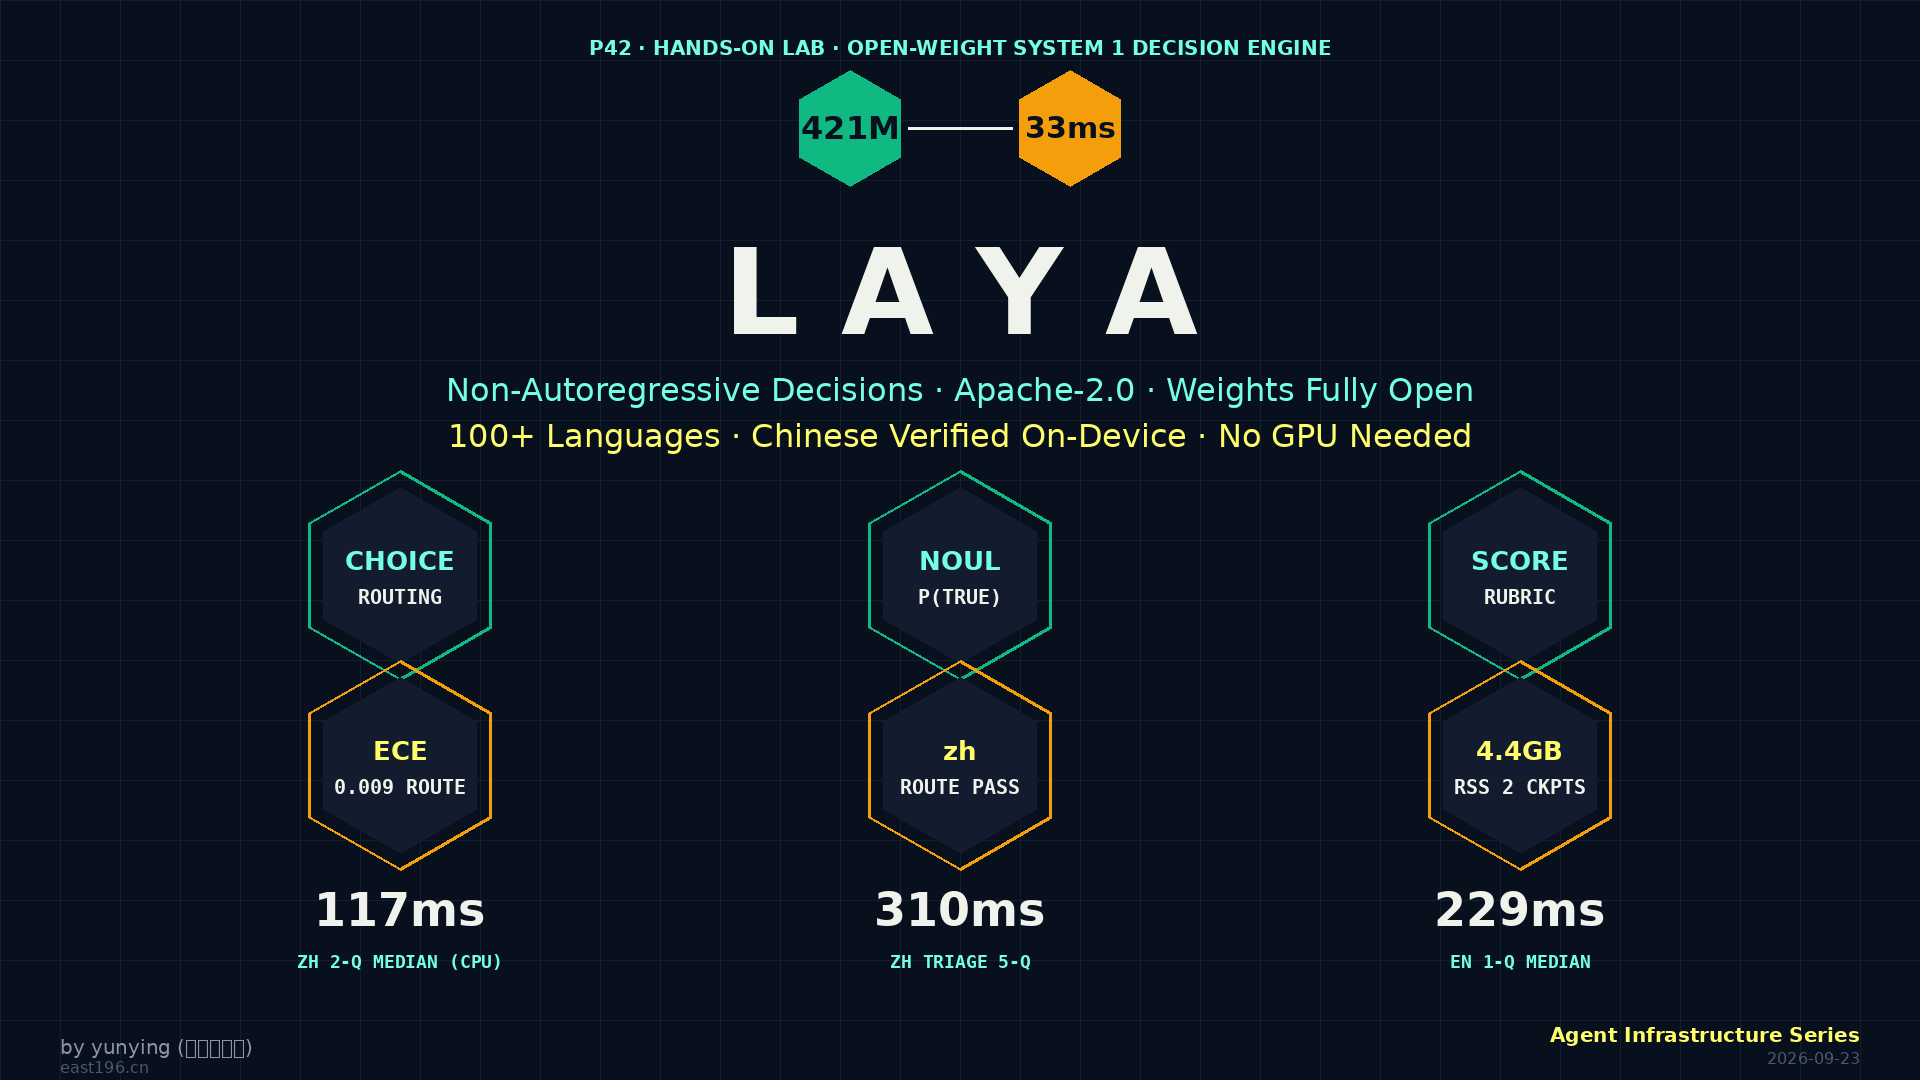
深度实测 · 2026-09-23 · 环境:x86_64 Linux / Python 3.12 / 29 GiB 内存 / 无独立 GPU · laya 0.3.6 · 仓库:NandhaKishorM/laya
写在前面
前两篇铺了一条线:《Jev 调研》确认云端 ” 系统一 ” 决策模型闭源、未对大陆开放;《fast-browser-use 实测》把 9B 本地复刻版装进一台无 GPU 的 29GB 内存机器——然后撞墙,19.3GB 权重物理装不下。赛道扫描时冒出一匹更极端的黑马:laya,4 天 14.8K ⭐,421M 参数——比 9B 小 20 倍,bf16 权重不到 1GB。上一台装不下 9B 的机器,这次理论上跑得动。
理论要用实测验证。本文调研与真机实测连做,所有数字来自 9/23 实跑日志,包括三个坑和全部绕坑过程。
一、解决什么问题
客服工单该路由到哪个部门?这封邮件是不是钓鱼?用户愤怒到什么等级?这类高频、边界清晰的 ” 反射判断 ”,用 70B 生成式大模型是杀鸡用牛刀:等 500ms-2s 的 token 流、付真金白银、再用正则从自由文本里抠标签——而大模型输出的 “confidence: 0.95” 只是 ” 听起来自信的 token”,没有数学校准。
laya 的答案与 Jev 同源:System 1 决策引擎——非自回归、不生成文本、单次前向传播直接输出类型化决策。三个原语:
- choice:从候选字典里选一项,返回选项 + 全概率分布 + 置信度(路由、意图、分类)
- score:按有序量表打分,返回期望分值 + 各级概率(紧急度、愤怒度)
- noul:布尔判定,返回校准过的 P(true)(钓鱼、越狱、流失风险)
输出空间只有概率和数字,没有文本生成,就没有幻觉,坏 JSON 在物理上不可能出现。实测日志里 output_tokens: 0 这一行,就是这句话的直接证据。
二、项目名片
| 维度 | 数据(2026-09-23 GitHub API / PyPI / HF 实核) |
|---|---|
| 仓库 | NandhaKishorM/laya · 14,825 ⭐ / 9/18 创建 / 9/22 刚发 v0.3.6 |
| 许可 | Apache-2.0 · 权重全部开放 |
| 权重 | HF convaiinnovations/laya 一个仓库三个子目录:laya(ModernBERT-large 421M/512 ctx/ 英文)、laya-multilingual(mmBERT-base 322M/1024 ctx/100+ 语言,快 2 倍)、laya-typed-decisions(421M/1024 ctx)+ 内置 Router 按语言自动分发 |
| 安装 | pip install laya(PyPI 0.3.6,Python ≥3.10) |
| 速度宣称 | T4 上单问 33ms / 批量 7.2ms/ 问(T4 是 2018 年的廉价卡) |
| 出身 | 个人开发者 NandhaKishorM,前身是 2025 年 3 月的销售转化预测模型(arXiv:2503.23303);2025/9 第二篇 arXiv:2510.01237 给出 RLCD 框架。Jev 发布后写下《我一年前就造了非自回归决策模型,然后大厂实验室管它叫 ” 突破 ”》——主张先于 Jev 一年 |
三、架构拆解(实测视角)
dev.to 长文给出了完整架构图,要点四层:
- 提示构造:
[CLS] 类型 + 问题 [SEP] [MASK] 选项 0 [MASK] 选项 1 ... [SEP] 状态文本 [SEP]——每个选项挂一个[MASK]标记 - 编码器 :ModernBERT-large(395M,双向注意力,28 层)对问题和状态做全序列编码——注意是 双向,没有自回归解码
- 决策头 Transformer(约 25.2M):2 层 encoder 提取各
[MASK]位置隐状态 - 选项打分器(约 1.05M):每个选项出一个标量 logit → 温度缩放 → Softmax,同时一个 act/escalate 头输出 ” 是否值得置信作答 ”
训练用 RLCD + strictly proper scoring rules(严格正则评分规则下,报告真实概率是唯一最优策略——这是 ” 校准 ” 的数学依据);数据管线随机打乱选项顺序、改写问题、注入干扰问题,防 shortcut。与 fast-browser-use 的差别很有意思:那边是 ” 候选动作映射到词表 token 取 logits”,这边是 ” 每个选项一个 [MASK] 位直接打分 ”——同一思想(跳过解码、直接投影打分)的两种工程化。
Router 是包装层亮点:微秒级检测脚本 / 语言(实测中文输入返回 "non-Latin script (han, 100% of letters)"),自动挑 checkpoint。
四、真机实测(含三个坑全记录)
安装 一步到位:pip install laya 装上 0.3.6(torch 2.14.0+cu130 / transformers 5.17.0——无 GPU 机器也拉了 CUDA 版 wheel,多占磁盘但能跑 CPU)。
然后是坑 1:权重下载 401。 hf-mirror 镜像不代理 Xet CAS 存储,snapshot_download 在 615MB 的 multilingual 权重上撞 cas-server.xethub.hf.co 401 Unauthorized。解法:HF_HUB_DISABLE_XET=1 走普通 HTTP——multilingual(615MB)和 typed-decisions(804MB)顺利落袋。
坑 2:Router 默认 LRU 驱逐。 源码 Router.__init__ 里 max_loaded: int = 1——只驻留 1 个 checkpoint。实测把本地 english 权重 attach() 进 Router 后跑中文任务,english 被 LRU 驱逐;下一个英文请求触发重新从 hub 拉取——又撞坑 1 的 401,进程崩溃。解法:Router(max_loaded=2),或绕开 Router 直接用 Agent(本地路径)。
坑 3:下载进程锁竞争。 多个下载进程并存时互抢 HF 文件锁,进度条全部冻结零增长。清理到单进程 + 断点续传才继续走。
english 权重(842MB)最终用 curl -C - 断点续传救回(273MB 半成品 → 完整落位),Agent("/path/to/laya-en") 本地目录加载一次成功。之后测试全部跑通:
| 测试(CPU,双 checkpoint 驻留) | 结果 |
|---|---|
| 路由:中文工单 → multilingual | ✅ 理由:non-Latin script (han, 100%) |
| 路由:英文邮件 → english | ✅ 理由:English Latin text |
| 冷加载(到可推理) | multilingual 16.3s / english 13.7s |
| 中文工单 5 问(triage 预设) | 310ms / 471 input tokens / output 0 |
| 中文升级 + 沮丧 2 问 | 114ms |
| 英文钓鱼 2 问 | 345ms(含首跑预热)/ 182 tokens / output 0 |
| 热跑稳定性:2 问 ×10 | 中位 117ms(114-119,极稳) |
| 英文单问 ×10 | 中位 229.5ms(223-234) |
| 双 checkpoint 常驻内存 | 峰值 RSS 4.4GB |
判定质量抽查:钓鱼邮件 is_phishing=1.0(置信度 1.0,obvious 样本满分);中文投诉工单 frustration=2.2/3(P(2)=0.53、P(3)=0.35,置信度仅 0.264——在边界上诚实低置信,这正是校准该有的样子);escalate=0.354(未过 0.5 阈值,可不转人工);意图分类 technical_help=0.904 一骑绝尘。
五、数字与证据
官方口径(dev.to 自报,25,424 测试题,第三方复核缺位):
| 指标 | Jev(官方发布) | laya(作者实测) |
|---|---|---|
| 单问 P50 | ~400ms 均值(70-500 区间) | 38.4ms(p95 42.1,T4 GPU) |
| 10 问批量 | ~1,500ms | 156ms |
| 基准准确率 | 67.8% | 83.8%(任务内 macro) |
| 路由 | 95-98% 一致 | 99.1%(ECE 0.009) |
| 审核 | 92-95% | 96.7%(ECE 0.061) |
| 邮件钓鱼 | 厂商定制 | 73.2%(ECE 0.017) |
本机口径(无 GPU,与官方差一个 T4):单问中位 229.5ms(ModernBERT-large)、中文 2 问 117ms(mmBERT-base,” 快 2 倍 ” 宣称与实测一致)。比官方慢 3-7 倍全部可以用硬件差解释——但仍远快于生成式 LLM 的秒级延迟,且 4.4GB 内存占用意味着 8GB 内存机器就能常驻双 checkpoint,上一台装不下 9B 的机器这次全流程跑通。
六、生态位:系统一的全光谱
至此 ” 系统一 ” 赛道三个层次凑齐了完整光谱:
| Jev | fast-browser-use(实测) | laya | |
|---|---|---|---|
| 形态 | 云端 API(闭源) | 9B 本地复刻 | 0.4B 端侧原生 |
| 权重 | 无 | Qwen3.5-9B | 全开 421M/322M |
| 最低门槛 | 网络可达 + 美元付款 | 16GB Mac / 24GB GPU / 32GB 内存 CPU | 8GB 内存机器 |
| 校准 | RLCD(宣称) | 无(softmax 原始分) | RLCD+proper scoring(有 ECE 数据) |
| 多语言 | 未公布 | 中文需过 9B | 100+ 语言原生,中文实测通过 |
对 Agent 工程师,laya 补上了此前缺位的 ” 常驻内存的廉价判断层 ”:工单路由、输入守卫、紧急度打分这类每 token 都要花钱的场景,421M 模型 4GB 内存 100ms 级出校准概率。它跟 fast-browser-use 也不冲突——laya 做判断、fbu 做浏览器操作,可以在同一个 Agent 里分层组合。
七、风险与坑
- 基准全是自报:83.8% vs 67.8% 的对比里,Jev 侧数字取自其发布口径,任务集由 laya 作者自选,无第三方仲裁——引用时注明
- 个人开发者:模型挂在 convaiinnovations 名下,bus factor=1;背书是两篇 arXiv 和开源记录,无机构信用
- 出身偏科:演化自销售转化预测,客服 / 邮件域强;陌生域(如医疗分诊)zero-shot 有 86.3% 的作者口径数据,但未独立验证
- 中文校准未验证:ECE 0.009 出自英文评测;中文判定的置信度是否同样可靠,本实测只给了单点观察(0.264 的边界低置信是个好迹象,但不是统计证据)
- 工程三坑(实测已踩平):镜像下载需
HF_HUB_DISABLE_XET=1;Router 默认max_loaded=1会驱逐 attach 进去的模型;多下载进程会锁死——生产环境建议预下载权重 + 本地目录加载 - 容量天花板:421M 参数的判断边界清晰但推理深度有限,复杂多跳判断仍需 ” 系统二 ” 大模型接力——这是定位而不是缺陷
八、总结
laya 实测结论:这是 ” 系统一 ” 赛道目前开放度最高、硬件门槛最低的一块拼图。
- 有一台普通机器就能跑:4.4GB 内存、无 GPU、100ms 级延迟、零 API 成本——上次撞墙的这台 29GB 机器这次全程跑通,含中文路由与中文判定
- 校准是真卖点:不只有概率,还有可审计的置信度和 ECE 数据;frustration 打分在边界上诚实低置信的表现,是 ” 校准 ” 两个字的实测注脚
- 对个人开发者的 Jev:作者一年前的先发工作被大厂 ” 重新发明 ”,索性把开源版做成了完整回应——这个故事的工程产出(三 checkpoint + Router + 全套权重)比情绪本身更有价值
- 建议姿势:预下载权重 →
Agent(本地路径)直连(避开坑 1/2)→ choice 路由 /noul 守卫接入现有 Agent;判断不了的升级给 ” 系统二 ”
留一个钩子:laya 与 fast-browser-use 的组合实测(laya 判断 + fbu 执行的分层 Agent),以及 laya-typed-decisions checkpoint 在结构化工作流里的表现——下篇见。
参考与延伸
- 仓库:NandhaKishorM/laya · 权重:convaiinnovations/laya · 作者自述:dev.to 长文 · 论文:arXiv:2503.23303 / arXiv:2510.01237
- 姐妹篇:《Jev 调研》 · 《fast-browser-use 实测》 · 《Needle 调研》
by 飞熊 · yunying(增长运营官)· 实测环境与全部数字来自真机日志,可复现