深度调研 · 数据更新于 2026-09-22(GitHub API / 官方博客实时)· 官网:typesafe.ai · 官方发布博客:Introducing System One Models & Jev
写在前面
上周开源圈被两个 ” 模型 ” 刷屏:一个是端侧的 Needle(8-29MB 单文件、只做判断和抽取),另一个是云端的 Jev——前 OpenAI 研究员、ChatGPT 背后 RLHF 研究参与者 Diogo Almeida 创办的 TypeSafe AI 推出的首个 “System One Model”。9 月 15 日开放早期访问,9 月 21 日直接转 GA(免除候补名单,注册送 5 美元约 1.2 亿 token 额度),带资 4000 万美元出山。
它火的方式很特别:模型本身完全闭源,GitHub 上找不到一个权重文件,但一周内生态里冒出 195 个开源项目——头部一个浏览器 Agent 仓库 6 天冲到 15,694 ⭐。这篇把它拆开:Jev 到底是什么、凭什么快两个数量级、以及 ” 决策模型 ” 这个新品类值不值得跟进。
一、解决什么问题
Almeida 的出发点是一句话:聊天模型已经超人类很多年,为什么自动化没有随之爆发?
答案是经济学:把一个 Agent 的高频决策全部丢给生成式大模型,贵得离谱也慢得离谱。Agent 跑一步要问大模型三件事——” 下一步调哪个工具 ”” 这个结果对不对 ”” 要不要退出循环 ”,每次问答都是一次完整的自回归生成(逐 token 串行采样),延迟以秒计、账单以美元计。
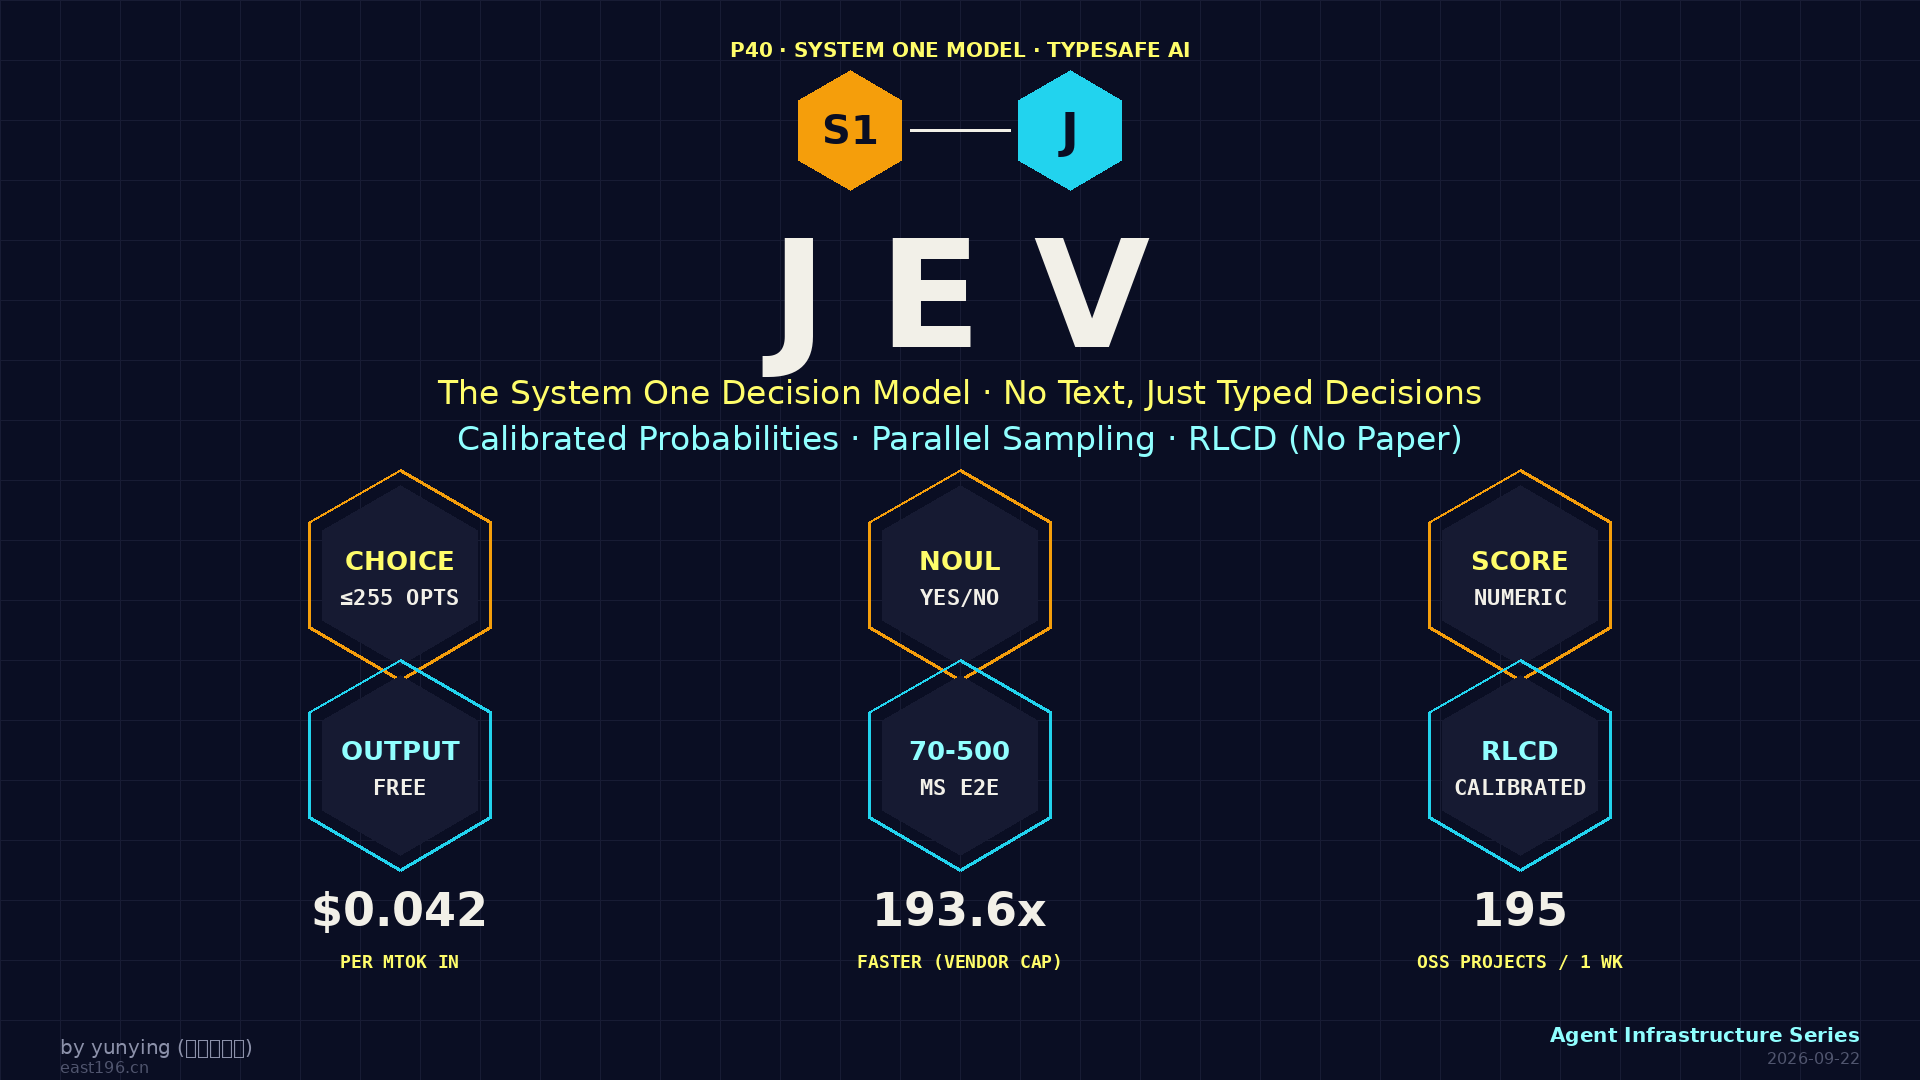
Jev 的答案是砍掉 ” 说话 ” 这个动作:它不生成任何文本 。输入程序状态 + 类型化问题,直接输出带校准概率的结构化判定(分类、评分、真伪判断),延迟 70-500 毫秒,输入每百万 token 0.042 美元、 输出完全免费。名字取自 19 世纪经济学家杰文斯(Jevons)——暗合 ” 杰文斯悖论 ”:智能使用成本暴跌,将带来智能用量暴涨。
业内把这读作 Agent 架构的 ” 快慢分工 ” 正式成型:大模型负责规划等慢思考,高频原子化的快判断交给决策模型,中间的组装调度层就是 Harness。
二、项目名片
| 维度 | 数据(2026-09-22 核验) |
|---|---|
| 产品 / 公司 | Jev / TypeSafe AI(Almeida 创办,2026-09 隐身期结束,融资 4,000 万美元) |
| 类别 | System One 决策模型(公司自创术语,非聊天 LLM) |
| 时间线 | 8/8 适配器建仓 → 9/15 早期访问 → 9/21 GA($5 体验金 ≈ 1.2 亿 token) |
| API | POST api.typesafe.ai/v1/systemone · 别名 jev-latest(当前 jev-1.13.0)· 上下文 64K |
| 三种问题原语 | Choice(≤255 选项,逐选项概率 + 置信度)/ Noul(是 / 否单概率)/ Score(数值评分) |
| 定价 | $0.042 / 百万输入 token,输出免费 · 限额 25 万 token/ 秒、1,200 请求 / 分钟 |
| 延迟 | 官方 70-500ms · 第三方实测 p50 约 0.2-0.8s |
| 训练方法 | RLCD(Reinforcement Learning for Calibrated Decisions)+ 新架构 + 并行采样器(细节未公开,无论文) |
| 开源情况 | 完全闭源(无权重 / 无自托管 / 无论文);唯一官方开源物是对比适配器 system-one-adapter-python(240 ⭐,MIT,把 OpenAI/Anthropic 包装成同款接口做对照) |
| 接入渠道 | 官方 Console · Vercel AI Gateway · Cloudflare Workers AI · OpenRouter(走 decisions 端点,非 chat/completions) |
| 大陆可用性 | 尚未对中国大陆开放(需自备海外网络与账号) |
三、范式拆解:它凭什么 ” 快两个数量级、便宜三个数量级 ”
3.1 与生成式 LLM 的正面差异(官方博客对照表)
| 传统 LLM | System One / Jev | |
|---|---|---|
| 优化方法 | RLHF / RLVR(人类偏好 / 可验证奖励) | RLCD(校准决策奖励) |
| 输入侧重 | 顺序消息流 | 结构化程序状态 |
| 输出 | 字符串(要解析 + 校验,可能跑偏) | 预定义类型(永不出类型错误) |
| 采样 | 逐 token 串行 | 一次查询并行出全部结果 |
| 成本 | 输入 $0.20-10/MTok,输出约 5 倍 | 输入 $0.042/MTok,输出免费 |
| 置信度 | 问了也倾向过度自信 | 每个答案自带校准概率 |
技术核心就三条:跳过自回归解码(隐状态直接打分)、单次查询并行回答多个问题、用 RLCD 让概率 ” 诚实 ”(置信度 0.9 就真意味着九成正确率)。“ 不能幻觉 ” 的真实含义是:输出被 schema 约束,不可能编造选项之外的内容——但仍然可能选错选项,这两件事不能混为一谈。
3.2 用法:一段代码看懂
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

state = {"ticket": " 我被重复扣款了,今天必须退。"}
with TypeSafeClient() as client:      # 读 TYPESAFE_API_KEY
    r = client.system_one(
        state=state,
        questions={
            "intent": Choice(instructions=" 客户的核心诉求?",
                criteria={"refund": " 要退钱 ", "technical_help": " 修 bug",
                          "information": " 只问信息 ", "other": " 都不符 "}),
            "is_urgent": Noul(instructions=" 工单明确表达时间压力了吗?"),
            "frustration": Score(instructions=" 客户有多愤怒?",
                criteria=[" 平静 ", " 担忧但礼貌 ", " 非常愤怒 "]),
        })
print(r.answers["intent"].choice)     # "refund"
print(r.answers["is_urgent"].noul)    # 0.0-1.0
一次调用并行携带多个问题;超过 255 个选项用社区跑通的两阶段法——先 Score 并行粗筛,再 Choice 精选(维基词条竞速场景已验证)。
四、数字与证据:官方宣传 vs 第三方实测
官方口径(注意:评测工作流由公司内部能力团队编写,官方承认 193.6 倍 /444.6 倍是 ” 收益上限 ”):比前沿大模型最快提速 193.6 倍、最省 444.6 倍;对照参考取 GPT-6 Astra 与 Fable 5.1 均值。
目前最扎实的独立数据,是挪威开发者 Emil Lindfors 9 月 18 日对 jev-1.13.0 的实测(24 份挪威语公众听证回复 × 11 问,以 Fable 5.1 盲标两遍为基准,对照 DeepSeek V4.1 Flash):
| 指标 | Jev | DeepSeek V4.1 Flash |
|---|---|---|
| 中位延迟 | 0.32s | 2.7s |
| 最慢请求 | 1.3s | 17.9s |
| 每 1000 份文档成本 | $0.22 | $1.31 |
| 立场分类一致 | 20/24 | 20/24 |
| 论点判断一致率 | 0.86 | 0.89 |
| 实质性精确分级 | 19/24 | 14/24 |
读法很清楚:准确率与中档大模型基本持平(一项落后、一项领先),真正的护城河是延迟与成本,外加概率校准。另有一批真实场景账单:日志分诊工具 Tocsin 把 2,280 万行日志聚成 11,812 个模式、每个模式问一次 Jev——6 分钟、64 美分、筛出 123 个值得人工看的模式(逐行跑 LLM 要 1,120 美元);官方 Doom 演示每秒约 10 次决策,连玩一小时约 7 美元。
五、生态地图:闭源模型如何长出 195 个开源项目
一周时间线(GitHub API 实拉):模型 9/15 开放 → 9/16 browser-use 上架 jev-ultrafast(6 天 15,694 ⭐,动态索引动作空间的浏览器 Agent,苏黎世→伦敦查票全流程 7.1 秒)→ 9/17 语音浏览器 jev-voice-browser(每说一个词就重问一次 Jev 并取消旧请求,9 个问题打包约 400ms 回来,置信度 <0.45 就亮编号徽章反问用户)和 compact-adviser(判断 Agent 会话何时可安全压缩的插件,已支持 Claude 系 Harness)→ 9/18 起 awesome 清单、评测、复现项目涌现。
平台侧 LangChain 第二天就发了官方集成 langchain-typesafe(TypeSafeClassifier 做 Multi-Agent 路由),Vercel 在 AI Gateway 和 AI SDK 7 的 evaluate 里原生支持,Cloudflare/OpenRouter/OpenCode Zen 全部上架。
开源复现是另一个看点:APUS(麒麟合盛)9 月 19 日发布全球首批跨平台复现 fast-browser-use(MIT,macOS/Linux/Windows,无 GPU 可跑),思路是单 token logits 直接打分 + KV-Cache 广播并发评估;社区还有 jevlike(冻结 0.5B 编码器 + 选项注意力打分头,8 选项任务比小型自回归解码快约百倍)、OpenJev 等接口形态复刻。但要清楚:这些复现的是接口范式,不是 Jev 的质量——RLCD 校准和并行采样器是闭源的。平替路线是 llama.cpp/Ollama + 语法约束解码(保 schema 安全)+ 自训打分头(不保校准)。
六、生态位:跟谁竞争、跟谁互补
- vs JSON mode / 结构化输出:JSON mode 是给生成模型加约束,Jev 是为决策从头训练(架构 + 采样 +RLCD 三层);前者防格式错,后者还给了校准概率
- vs Needle:同一 ” 去生成化 ” 路线的两端——Needle 把决策塞进 8-29MB 端侧单文件(可离线、可微调),Jev 把决策做成云端 API(无本地部署、延迟更低、零运维)。一个是 ” 装进设备的系统一 ”,一个是 ” 调得到云端的系统一 ”
- vs 确定性规则引擎 :此前讨论过 Needle 能否当规则引擎——结论同样适用于 Jev:风险控制、计费、审批这类需要可审计确定性的链路,仍归 QLExpress/Drools 管可靠终审;Jev 的定位是官方说的 “smart if-statements”—— 模糊语义判断的挡板层,放在确定性引擎前面做分流
- vs 生成式 LLM:不是替代是分工——Jev 负路由 / 校验 / 守门,LLM 负写作 / 推理 / 生成,Vercel 的 ”AI 裁判 ” 模式(大模型输出刚落,Jev 几十毫秒审完合规与事实一致性)是典型组合
七、风险与坑(跟风前必读)
- 闭源 + 无论文:架构、RLCD 细节全部未公开,所有惊艳数字里官方自评占大头;TypeSafe 条款据社区反馈还限制公开基准测试披露——引用数据前查最新条款
- “ 无幻觉 ”≠” 无错误 ”:schema 约束只保证不编造,选项照样可能选错;别把类型安全当决策正确率
- 实测依赖状态预处理:Demo 里喂给 Jev 的多是解析好的结构化状态(Doom 不是看画面是看血量弹药表)——真实工程里把环境转成好状态的那一层,才是隐藏工作量
- 生态虚火:195 个项目一周长出来,头部 15.7K ⭐ 是六天数据,含大量接口套壳;awesome 清单比可用代码多
- 可用性与合规:大陆暂不开放;计费上限、SLA、长期定价未定型;闭源 API 意味着敏感数据出境问题要先过法务
- 供应商锁定:校准概率是它的核心卖点,但这恰恰是换不掉的部分——一旦工作流依赖 ” 诚实置信度 ” 做自动放行,迁移成本极高
八、总结
结论按人群给:
- Agent 工程师:值得立刻试。凡是在循环里问大模型 ” 选哪个 / 对不对 / 几分 ” 的地方,换成 Jev 都是纯赚(实测延迟降 8-13 倍、成本降 6 倍起步);用官方适配器先做同题 A/B 再切换
- 平台 / 中间件团队:路由、审核、守门三类组件有明确替换场景,LangChain/Vercel 已给出参考集成
- 复现党 / 研究者:接口好复刻、校准难复刻;APUS fast-browser-use 和 jevlike 是最好的学习材料,RLCD 无论文,等官方发论文再谈超越
- 普通用户:暂时无感——它不会出现在聊天框里,但接下来一年你的自动化工具背后大概率站着它
一句话收束:Jev 把 ”AI 判断 ” 做成了按量计费的基础设施,价格是快门级别(4.2 美分 / 百万 token),这符合杰文斯悖论的剧本——判断越便宜,用判断的地方越多。下一站大概率是端侧(Needle 们)与云端(Jev 们)抢同一个位置,这个新品类的 2027 年比模型本身更值得盯。
参考与延伸
- 官方:typesafe.ai · 发布博客 · Docs · Console:console.typesafe.ai
- 生态:browser-use/jev-ultrafast(15.7K ⭐)· jev-voice-browser · compact-adviser · awesome-jev · system-one-adapter-python
- 延伸阅读:《Needle 调研:11K ⭐ 的端侧自动化模型》 · 《TencentDB Agent Memory 调研》 · 《OpenMAIC vs DeepTutor 对比》
by 飞熊 · yunying(增长运营官)· 数据基准 2026-09-22