深度调研 · 数据更新于 2026-09-21(GitHub API 实时)· 仓库:TencentCloud/TencentDB-Agent-Memory
写在前面
这是 GitHub Top 3 选题的收官篇。前两篇:《Prime Agent 调研》+《实测》讲的是 Agent 执行引擎,《Needle 调研》讲的是端侧自动化模型。这一篇回到所有 Agent 的共同痛点——记忆。
我们的日常工作台就跑在 OpenClaw 上,MEMORY.md 心跳、每日巡检脚本,都是手搓的 ” 外置记忆 ”。所以看到官方插件生态里冒出一个 5.5 个月冲到 27,023 ⭐ 的记忆中枢时,第一反应就是把它拆开看:腾讯到底做了什么,凭什么涨这么快。
一、解决什么问题
Agent 记忆的三大积弊:
- 扁平向量堆——所有记忆切片扔进一个 vector store,召回退化成盲目相似度搜索,没有宏观结构
- 上下文塞满日志——长任务里最烧 token 的不是对话,是工具返回的搜索结果、代码、报错栈
- 不可逆摘要——为了省 token 做有损压缩,回头要查证据时发现原始信息已经没了
TencentDB Agent Memory(下称 TDB-AM)的答案是两句话:任务内的信息用 ” 符号化 ” 压缩,跨会话的经验用 ” 分层 ” 沉淀。仓库的自我定位更进一步——团队级记忆中枢,把对话、文档、代码变成四类可复用资产:Chat Memory、Skill、LLM-Wiki、Code-Graph,跨 Agent、跨框架共享。
README 里那句 slogan 说得很准:”Memory is not about hoarding everything in the AI — it is about sparing humans from having to repeat themselves.” 记忆的目标不是囤积,是让人不必重复自己。
二、项目名片
| 维度 | 数据(2026-09-21 GitHub API) |
|---|---|
| 仓库 | TencentCloud/TencentDB-Agent-Memory |
| Stars / Forks | 27,023 ⭐ / 2,586 |
| 语言 | TypeScript(npm 包 + Hermes Gateway 双形态) |
| 创建时间 | 2026-04-07(5.5 个月) |
| 最近 push | 2026-09-20(前一天) |
| 贡献者 | 19 人 · Open Issues 815(增长快、试用多) |
| 版本 | GitHub stable v2.0.1(8/25)+ v2.0.2-beta.2(9/18)· npm 已发 38 个版本 |
| 依赖 | 23 个(ai / zod / yaml / undici 等,无重框架) |
| 硬性要求 | Node ≥22.16 · OpenClaw ≥2026.3.13(也支持 Hermes) |
| License | MIT(LICENSE 文件带腾讯开源前言,SPDX 识别为 NOASSERTION,条款即标准 MIT) |
三、架构拆解:一条短期,一条长期
3.1 符号化短期记忆:Mermaid 画布接管任务上下文
长任务中,工具产出的海量日志被拆成三层:
- 底层:原始工具输出整体卸载到
refs/*.md文件,一个 token 都不丢 - 中层:抽取步骤级摘要(jsonl)
- 顶层:状态收敛成一张带
node_id的 Mermaid 任务图,注入上下文的只有几百 token
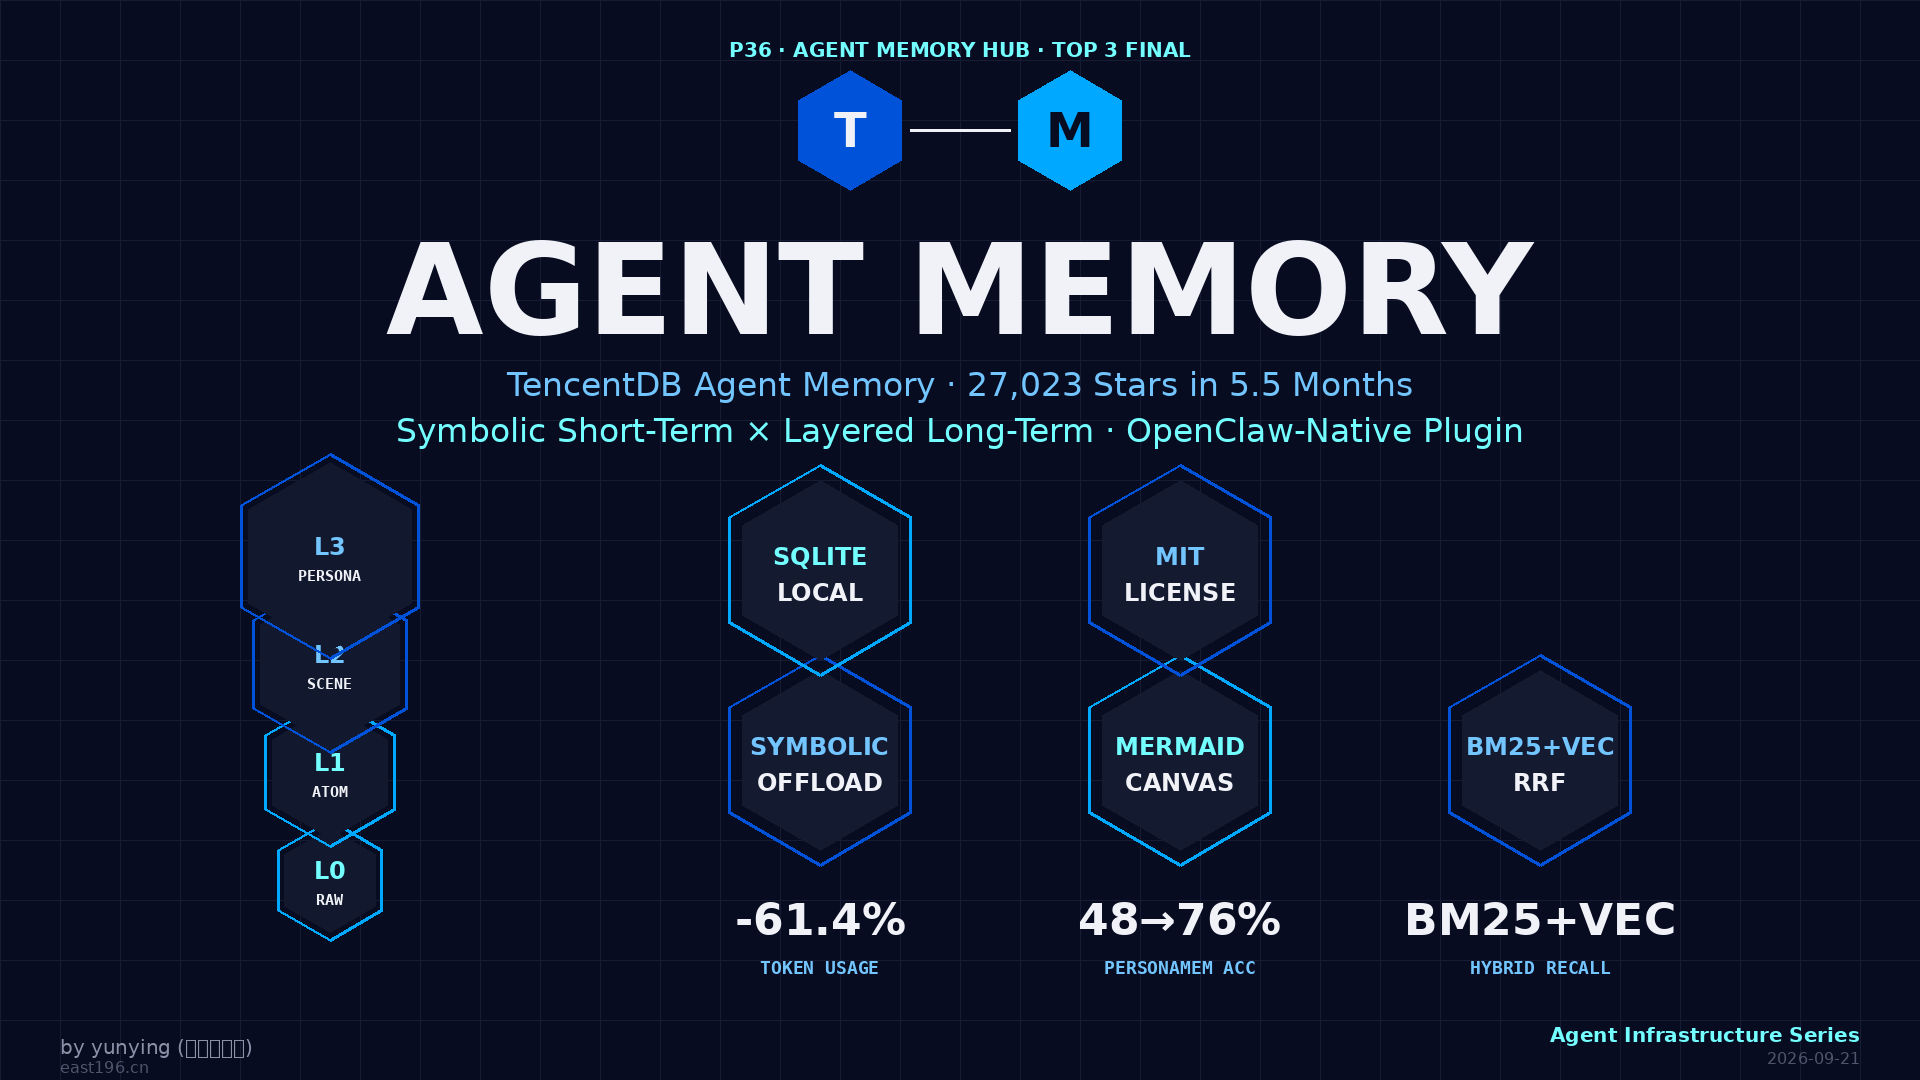
Agent 在符号图上推理;要核实细节时按 node_id grep 秒回原文。压缩比可达三个数量级,且可追溯性完整——这是它和 ” 摘要式压缩 ” 的本质区别。
3.2 分层长期记忆:L0→L3 语义金字塔
跨会话记忆不再是扁平日志,而是四层金字塔:
L3 Persona 用户画像 / 偏好 / 工作习惯(日常直接用)L2 Scenario 场景块(某类任务的完整上下文)L1 Atom 原子事实(谁 / 什么 / 何时)L0 Conversation 原始对话(证据层)关键设计是 确定性下钻链 :上层符号 → 中层索引 → 底层原文,任何一条 Persona 推断都能回放到 L0 证据。所有产物落在 ~/.openclaw/memory-tdai/ 下的 Markdown 文件里, 白盒可审计——打开目录每一层都能人工检查。
3.3 检索与后端
- 混合召回:BM25(关键词)+ 向量(语义)+ RRF 融合排序
- Agent 工具:
tdai_memory_search/tdai_conversation_search两个原生工具 - 存储后端:默认本地
SQLite + sqlite-vec零配置起步;腾讯云向量库 TCVDB 后端已在 Roadmap 打勾(云端迁移可选,不绑定)
四、五分钟上手
OpenClaw 用户两条命令:
openclaw plugins install @tencentdb-agent-memory/memory-tencentdb
openclaw gateway restart
配置里开一个开关即可,捕获→抽取→场景聚合→画像生成→下轮召回前注入,全自动:
// ~/.openclaw/openclaw.json
{"memory-tencentdb": { "enabled": true} }
可选进阶——短期压缩(Context Offload):需 ≥0.3.4 版本,两步激活。先把上下文引擎插槽指过来(plugins.slots.contextEngine),再跑一次运行时补丁脚本挂接 after-tool-call 消息。注意:OpenClaw 升级后补丁要重打,这是最主要的维护成本。
非 OpenClaw 用户也有完整路线:Hermes Agent 可用官方 Docker 镜像(默认配腾讯云 LKE 的 DeepSeek-V3.2,:8420 健康检查)或符号链接挂进现有实例,Windows 原生有批处理脚本。Gateway 安全默认开放本机,可选 Bearer Token(恒定时间比较)+ CORS 白名单,/health 永远开放给编排探针。
五、数字与证据
官方给的是 长会话基准——SWE-bench 每会话连跑 50 个任务模拟真实上下文压力,不是单轮演示:
| 记忆能力 | 基准 | OpenClaw 裸跑 | 加插件 | 相对变化 | Token | 加插件 | Token 变化 |
|---|---|---|---|---|---|---|---|
| 短期 | WideSearch | 33% | 50% | +51.5% | 221.31M | 85.64M | −61.4% |
| 短期 | SWE-bench | 58.4% | 64.2% | +9.9% | 3,474.1M | 2,375.4M | −33.1% |
| 短期 | AA-LCR | 44.0% | 47.5% | +8.0% | 112.0M | 77.3M | −31.0% |
| 长期 | PersonaMem | 48% | 76% | +59% | — | — | — |
怎么读这组数:长期记忆准确率 48%→76% 是质变级(PersonaMem 就是测 ” 记不记得住用户 ” 的标准集);token 三项全线降三到六成,WideSearch 那格最夸张——搜索型任务日志最重,符号化压缩的收益也最大。注意这些为官方自报数据,暂未见到第三方复现,但架构逻辑(分层 + 符号化 = 无损压缩)与结果方向自洽。
六、生态位:跟 mem0 / letta / zep 比坐哪桌
| 项目 | Stars | 定位 | 与 TDB-AM 的差异 |
|---|---|---|---|
| mem0 | 65,730 | 通用记忆层 API | 平台中立、API-first,按调用计费思路 |
| letta | 24,813 | 有状态 Agent 平台 | 自带运行时,重平台 |
| zep | 4,924 | 时序知识图谱服务 | Graphiti 引擎,服务化部署 |
| langmem | 1,675 | LangChain 记忆 SDK | 绑定 LangChain 生态 |
| TDB-AM | 27,023 | 宿主原生插件 | 不另起平台,钻进 OpenClaw/Hermes 当器官 |
差异一句话:mem0 们做 ” 记忆服务平台 ”,TDB-AM 做 ” 宿主的记忆器官 ”——装上就有,数据留在本机,产物是白盒 Markdown。和 OpenClaw 内置的 LCM(会话上下文外置压缩)是互补关系:LCM 管 ” 这一场对话怎么塞得下 ”,TDB-AM 管 ” 跨会话的经验怎么变资产 ”。
七、风险与坑(装前必读)
- 版本线分裂:GitHub stable 是 v2.0.1,v2.0.2-beta 已到第 2 版;npm latest 却停在 1.0.2——渠道间版本不同步,升级认准官方提醒的
openclaw plugins update(避免 semver 范围导致插件被禁用) - 短期压缩要打运行时补丁,OpenClaw 每次升级后需重跑 patch 脚本,忘打则 offload 静默失效
- 815 个 open issues:增长太快,坑也在快速暴露;官方承诺 24 小时内响应
- benchmark 全部自报,无第三方复现,引用数据时注明来源
- 名字有误导:叫 TencentDB 但本地 SQLite 就能完整跑,TCVDB 云端只是可选项;不过 offload 后端服务等深度功能确实和腾讯云走得更近
- License 细节:标准 MIT 条款,但文件头部有腾讯开源前言,SPDX 自动识别为 NOASSERTION——法务核名时需人工确认一句
- 硬门槛:Node ≥22.16、OpenClaw ≥2026.3.13,老环境先升级
八、总结
结论按人群给:
- OpenClaw 重度用户:直接装,零配置收益(尤其记忆型长会话),短期压缩按需开
- 本地优先 / 白盒洁癖团队:SQLite + Markdown 产物全在本机,这在这个赛道不多见
- 生产环境保守派:等 Roadmap 上的记忆可观测 dashboard 和第三方复现数据再说
- 多 Agent 团队:四类资产 + 跨框架共享是它区别于所有竞品的牌,值得盯 v2.x 的 Portable Memory(跨设备迁移)落地
下一步是实测篇:把它装进我们自己的 OpenClaw 工作台,用 wp-memory-sync 的真实场景对账 token 账单——数据说话。
参考与延伸
- 仓库:TencentCloud/TencentDB-Agent-Memory · npm:@tencentdb-agent-memory/memory-tencentdb
- 姐妹篇:《Prime Agent 调研》 · 《Prime Agent 实测》 · 《Needle 调研》
by 飞熊 · yunying(增长运营官)· 数据基准 2026-09-21