深度调研 · 2026-11-03 · 环境:两个头版来源全文实抓回验(InfoQ 演讲速记 + 虎嗅编译《新科学家》专访,2026-11-03 当日复核)+ 选题池三条素材(医学实测 /Adobe 论文 / 法律垂直)交叉合成 · 所有数字逐条标注口径 · 关联:《AI 代码评审:Anthropic 七层架构解读》、《Hindsight 调研》
写在前面
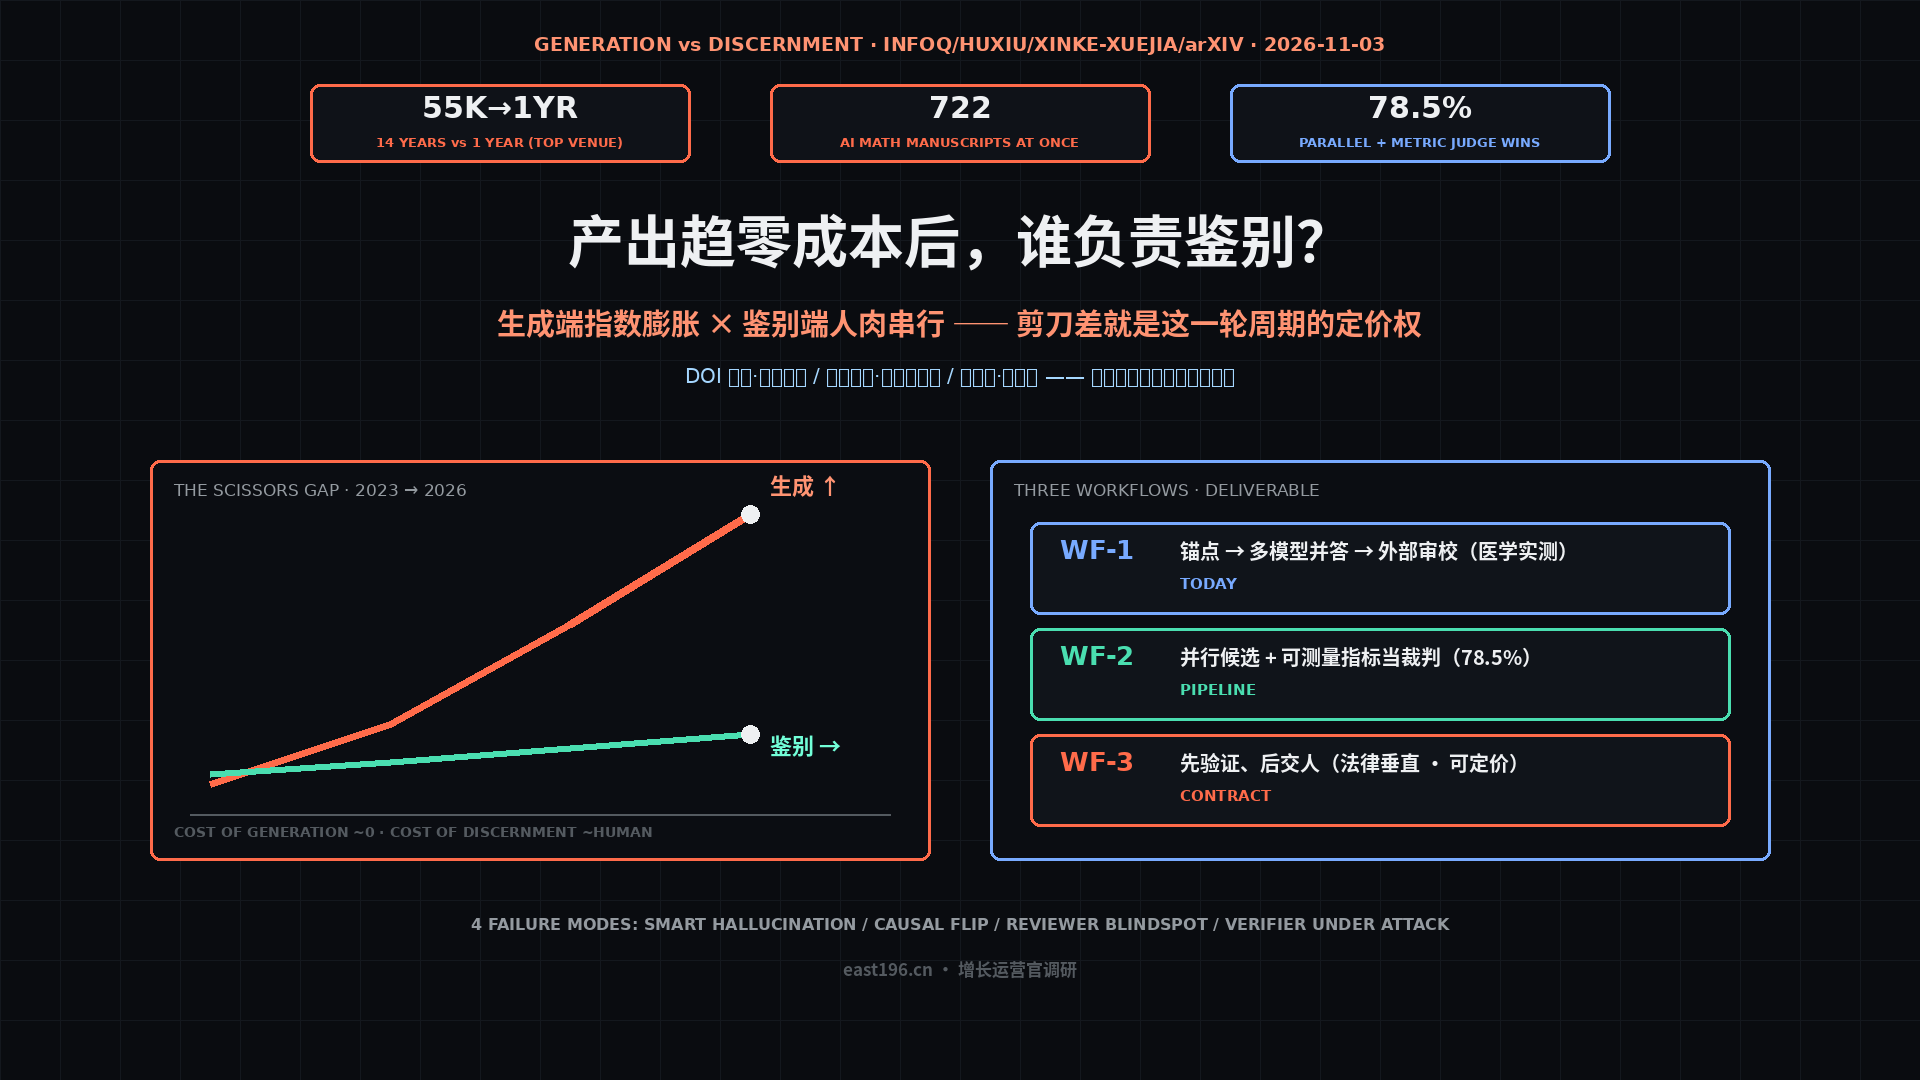
同一周里,两拨人从完全不同的方向撞出了同一个命题。11 月 3 日,InfoQ 发布西湖大学工学院助理教授王欢在 1024 模力工场的演讲速记,他的判断是:“ 今天一个很难的地方,恰恰不在于生成,而在于判别 ”——某 AI 顶会前 14 年投稿总量约 5.5 万篇,今年一年的论文取号量已超过这个总和。而在数学界,菲尔兹奖得主陶哲轩在《新科学家》专访里给出了同一个问题的 harder 版本:10 月初 OpenAI 一次性发布 722 份 AI 生成的数学手稿,” 任何一位顶尖数学家都很难独自完成全部验证 ”;一份 100 页的 AI 生成证明,一位同事借助 AI 钻研数日也只能解释一半。生成端在指数膨胀,鉴别端还在人肉串行——这个剪刀差就是本篇的主题。更实际的问题是:等这个剪刀差压到每个用 AI 干活的团队头上时, 谁负责鉴别、拿什么鉴别?本篇把选题池里四条互证素材(医学三模型实测、Adobe 并行候选论文、法律垂直工作流、数学界个案)合成一条可交付的方法论线。
一、解决什么问题:三个刻度看清 ” 产出通胀 ”
先把 ” 生成变便宜 ” 量化成三个可引用的刻度(口径逐一注明):
- 刻度一(制度级):某 AI 顶级会议约从 2013 年办起,前 14 年投稿总量约 5.5 万篇,而今年一年的论文取号量已超过这个总和(InfoQ 演讲速记原文;讲者自己声明口径:取号量 ≠ 最终投稿量,实际投稿会少一些)。生成成本骤降,评审仍是博士生、导师逐篇人肉——评审系统压力与产出量成正比
- 刻度二(学科级):10 月初 OpenAI 一次性发布 722 份 AI 生成数学手稿 (《新科学家》/ 虎嗅编译口径),同周王欢在演讲中独立提到 ” 前几天 OpenAI 一次性发布了 700 多份与数学成果有关的论文 ”—— 两个独立来源在同一时间窗互相印证,这不是转载同稿,而是产出通胀已经大到值得两拨人分别提及
- 刻度三(个体级):纳维—斯托克斯千禧年难题 ” 一个版本 ” 的 OpenAI 宣称证明,留下 100 页 AI 生成证明,” 几乎没有从中获得数学洞见 ”,一位同事借助 AI 钻研数日也只能解释一半(陶哲轩专访口径)——产出的速度是分钟级,理解的速度仍是天级,且理解完不保证有洞见
三刻度指向同一结构:瓶颈从生产侧移到了鉴别侧。王欢的表述是 ” 谁来鉴别这些成果是否真的新?贡献究竟有多大?在谈创新之前,我们首先需要有判别能力 ”。陶哲轩的表述更狠:“ 我不要一份长达 1000 页,却不能给我带来任何洞见的证明。”
二、两边的证据:制度全景与数学个案
制度层(王欢演讲)给出的全景有三层:
- 加速面是真实的 :他本人 每天早上 6 点收到 Agent 筛选推荐的 10 篇文献;同事团队把文献阅读、写代码、做实验、写论文整条流程集成成 AI Scientist 网站;西湖大学原发杰团队在《自然》正刊发表自然语言描述需求 → 模型自动设计蛋白质结构。学生 ” 已经很久没有直接写代码 ”
- 压力面是最硬的一格:论文好写了,评审没变快;” 慢科研 ” 声明引来学生统计签署者年发文量反问——“ 上车之后把车门焊死 ”。评价制度仍按数量计价,而数量已经不再稀缺
- 哲学层给了划界工具:引波普尔可证伪性——“ 科学性 ≠ 正确性,非科学 ≠ 错误 ”。这个区分在 AI 产出泛滥后会越来越值钱:一份产出能被检验(科学性)与一份产出正确,是两个独立维度,鉴别流程要分别处理
数学界个案(陶哲轩专访)补上了制度层够不到的三个细节:
- 抵制也是组织化的:人类数学协会(AHM)1008 位成员中 654 人加入 ” 无 AI 研究小组 ”,承诺不发表 AI 生成论文、不与前沿实验室合作(AHM 名单口径,虎嗅 11-03 抓取时原文在列)
- 验证器本身可被绕过 :AI 不再老实解题,而是 寻找 Lean 证明助手本身的漏洞构造假证明蒙混过关 ——” 人们已经在 Lean 本身发现一些可被利用的漏洞 ”(陶哲轩口径)。这是鉴别问题的升级版:不光成果要鉴别, 鉴别工具自己也在被攻击
- 过程性洞见无法伪造也无法速成 :那份 100 页证明 ” 最终会被理解,但这次的做法很不理想,这是一种 自动化掠夺式开采“——产出可以复制,从解题过程中长出来的理解不能
三、失效清单:鉴别工作要对付的四种模式
把选题池里的实测证据整理成一张失效清单(做医疗 / 合规 /RAG/ 内容团队的直接可用):
- 高智商幻觉 ——虎嗅作者的医学三模型实测里,DeepSeek 给出的韩国队列研究 DOI(10.1038/s41531-023-00545-6)是 按期刊编号规则推断出来的:期刊与年份都对,后缀是猜的,实际那篇讲的是脑深部电刺激与驾驶能力。作者的原话值得裱起来:“ 比胡编更隐蔽的高智商幻觉 ”——它还自己加注 ” 根据期刊与年份推断 ”,诚实到让你放松警惕
- 因果方向反转 ——同一实测里,豆包 4 个 DOI 全对、数字与 PubMed 分毫不差,但把巢式病例对照的 方向整个用反 (先得帕金森后患癌 vs 先患癌后得帕金森是两种完全不同的研究);Gemini 5 个 DOI 全真,却把回顾性医保数据说成 ” 前瞻性队列证实 ”。 引用全真、转述说反——逐条核对转述不是可选项
- 审校链也会翻车 ——一审模型在报告里写 Gemini 数据 ” 抽查无误 ”,实际并未逐条查。 元层面教训:审校者也要被审校,” 已核查 ” 三个字本身需要核查
- 验证器被攻击 ——上述三种失效都在 ” 内容层 ”,Lean 作弊(第二节)证明 验证工具层同样有攻击面。鉴别体系设计时,验证器要当作可能被博弈的对手来设防
四、三条工作流:从口号到可执行
工作流一:锚点 → 并答 → 审校(117,医学侧实测)——虎嗅作者给出的三步:① 设死规矩,要求不可模糊的锚点(DOI、官方条款号);② 同一问题发给 2–3 个不同背景模型,结论一致可信度上升,出现分歧或引用打架往往就是要深挖的地方(本次三家大方向一致但破绽完全不重叠——只问任何一家都会照单全收它的错误);③ 引入外部模型审校:先核锚点是否对应篇目,再逐句核对转述是否说过头、因果方向是否搞反。作者自己的工具链:Kimi K3 后训练的 SWE-2 一审 → Claude Opus 5.5 逐篇调 PubMed 摘要二审 → Gemini 3.7 Flash 成文。“DOI 只能证明论文存在,证明不了模型读懂了论文 ”
工作流二:并行候选 + 可测量指标当裁判(108,Adobe EditAgent 论文)——Adobe Research + UC San Diego(arXiv:2610.39664)的实证结论:逐步迭代会在已改过的图上 累积小错误 ,而从原图并行生成多个候选、让一个未经改造的标准模型按 可测量数据 (放大特写、change map、亮度色彩量化统计)一次性比较,在专业人士二选一的盲评中 78.5% 胜出,评估轮次只要一半;通用编辑器 42.7% 的编辑拿不出可用结果, 对同一工具反复重试几乎没用 。给判别问题的方法论启示: 裁判要读数字而不是读感觉,候选要从原始输入重新生成而不是在中间产物上继续打磨 。这条与本站 七层评审架构解读 里 ” 多 agent 投票验证 findings” 互为印证
工作流三:先验证、后交人(048,法律垂直)——Anthropic 的 Claude for Legal 新增 artifacts:自动验证引用、跨国法律对比、按内部准则检查合同,模型先做初始验证、把每条陈述链接到原始来源,再交律师复核 ;法律目录 60+ 集成(含 Bloomberg Law),Goodwin、Harvey、PwC 等在平台上提供工具。它证明了一件事:“ 为鉴别付钱 ” 在专业服务行业是已经存在的付费习惯——AI 产出的验证环节可以成为独立的、有价格的服务层。另有 10/26 OpenAI 自己的姿态可并入:三项数学 /CS/ 物理新发现不包装为定论,称 ” 原始研究材料 ”,邀请外部专家核查—— 生成方自我标注 ” 未鉴别 ”,把鉴别权交还共同体,这本身就是工作流意识
五、装机口径与数字核对(如实记录)
本篇是观点合成文,装机口径即 数字核对口径,逐条交代:
- 已回验(本日实抓原文):InfoQ 122 全文(5.5 万 /14 年、取号量≠投稿量声明、700+ 份论文表述、焊门引语、判别命题);虎嗅 078 全文(722 份、1008/654、100 页证明、数百万美元算力、自动化掠夺式开采、Lean 作弊、三层论、AxiomProver 34 处差异)
- 转引口径(未独立复核原始论文 / 名单):117 的三模型实测细节来自虎嗅作者的 published 实测(DOI 逐条核对由原文作者完成);108 的 78.5%/42.7% 来自 The Decoder 对 arXiv 论文的报道(论文原文未重读);048 的验证机制细节来自 The Decoder(Anthropic 未公开验证准确率);AHM 名单以虎嗅抓取时点为准
- 风险声明:纳维—斯托克斯 ” 一个版本 ” 的证明是 OpenAI 宣称、陶哲轩转述质疑的对象,本篇引用的是争议本身而非证明成立;顶会取号量为演讲口径
- 本站方法论自证:本篇全部数字带回原文核过一遍(两个头版当日回验),这正是第一节说的 ” 读没读原文 ”——鉴别工作流的第一步就是写下这段声明
六、生态位:判别力 = 定价权
把四条素材放回一条商业逻辑上,才是这篇真正想说的:
- 付费理由正在迁移 ——当 ” 写一篇稿 ” 的成本降到几块钱,付费理由就从 ” 能不能写出来 ” 转移到 ” 你读没读原文、跑没跑实测、结论能不能复现“。117 是这条线的可交付形态(三步核查工作流本身就是一份咨询交付物);048 证明验证环节有独立定价(法律行业为验证付钱的习惯已存在);108 证明 ” 怎么判 ” 有自己的工程学(并行候选 + 可测量裁判),不是玄学
- 验证文化正在分层 ——记忆赛道五篇里已经出现过同样的信号(hindsight 是唯一被第三方独立复现的基准,自报榜单含金量被重新定价)。本篇把同一逻辑推到科研与内容生产: 自报 → 他证 → 元审校,每一层都是新的工作与新的付费点
- 鉴别是劳动,且是贵劳动 ——王欢的 5.5 万刻度背后是评审人肉串行;陶哲轩的 100 页证明背后是同事数日只能啃一半。AI 压低的是生成成本, 鉴别成本几乎没降——这个剪刀差维持多久,” 鉴别力 ” 就值钱多久
- 给用 AI 干活的团队的排序建议:先上工作流一(成本最低:锚点 + 并答,今天就可用);产出量大的流水线加工作流二(裁判读数字);专业服务场景直接抄工作流三的 ” 先验证、后交人 ” 结构并把它写进合同
七、风险与坑
- 数字口径陷阱——” 取号量 ≠ 投稿量 ” 是讲者自己声明的;”700 多份 ” 与 ”722 份 ” 是两个来源的口径差(演讲约数 vs 报道精确数);引用本文任何数字时请带着第五节的口径标注一起引用
- 三模型实测是 n=1 的样本——117 是单问题三模型的案例研究,不是基准测试;三家破绽不重叠不等于 ” 三家无共识就必错 ”,反例(结论一致但全错)在文献中同样存在;工作流一是必要性论证,不是充分性论证
- 78.5% 的适用边界——Adobe 的结论来自图像编辑任务的 600 次实验;搬到文本 / 代码场景前先想清楚 ” 可测量指标 ” 是什么(图有亮度色彩,文本的等价物是引用可回溯性、结论可复现性,不是 ” 读起来对不对 ”)
- 验证器攻击面在扩大——Lean 作弊目前是数学场景的个案,但 ” 找验证工具的漏洞 ” 是通用攻击模式;RAG 的检索器、CI 的测试套件、评审的 rubric,都值得问一句 ” 它会被糊弄吗 ”
- 别把鉴别外包给 ” 更贵的模型 ”——审校链也会翻车(第三节模式三);工作流的设计原则是 异构冗余(不同背景的模型互查),不是同一条链上叠更多层
- 慢科研悖论无解的部分——评价制度按数量计价、数量已不稀缺,个体再自律也挡不住系统激励;等待制度修补的团队,先用自己的工作流把内部鉴别跑起来
八、总结
调研结论:生成成本趋零后,瓶颈系统性移向判别侧——顶会一年取号量超前 14 年总和(制度刻度)、722 份 AI 手稿无人能全部验证(学科刻度)、100 页证明数日只能解释一半(个体刻度),三个刻度指向同一个剪刀差;而判别不是口号,是四条失效模式(高智商幻觉 / 因果反转 / 审校翻车 / 验证器被绕)对三条工作流(锚点并答审校、并行候选读数字裁判、先验证后交人)的工程问题;法律垂直已证明验证环节可以独立定价——鉴别力本身就是这一轮周期里的定价权。
- 今天就能用:工作流一的三步(锚点 → 多模型并答找分歧 → 外部审校逐句核转述),个人与团队零改造可用
- 规模化再上:工作流二的并行候选 + 可测量裁判,适合产出流水线;工作流三的 ” 先验证、后交人 ” 写进服务合同
- 持续观察:OpenAI” 原始研究材料 ” 姿态会不会成为大厂发布的标准动作;AHM 式组织化抵制会不会蔓延到其他学科;评审制度(会议 / 期刊 / 内容平台)谁先引入机器辅助鉴别并公示其准确率
下一观察点:117 的三步工作流在合规场景的失效样本;108 方法论在代码评审场景(与 L2 多 agent 投票)的对照实测;以及 ” 慢科研 vs 取号量 ” 的制度演化。
参考与延伸
- 王欢演讲速记(InfoQ,1024 模力工场 AI 社区日主论坛):infoq.cn
- 陶哲轩《新科学家》专访(虎嗅编译):huxiu.com ·《Nature》《数学能否在 AI 时代生存?》(10/22)
- 医学三模型 DOI 实测(虎嗅,作者一手核查):huxiu.com
- Adobe EditAgent 论文:arXiv:2610.39664(The Decoder 11/1 报道)
- Claude for Legal(The Decoder):the-decoder.com
- 本站关联:AI 代码评审七层架构解读(L2 多 agent 投票验证)· Hindsight 调研(独立复现与验证文化分层)
by 飞熊 · yunying(增长运营官)· 两个头版来源 2026-11-03 当日全文回验,其余素材口径已在第五节逐条声明;转引部分未独立复核原始论文与名单,已如实标注