深度解读 · 2026-10-29 · 原文:How the Claude Code team does code review(claude.dev,2026-10)· 本篇为 ”AI 代码评审 ” 系列第 1 篇(理论解读),后续四篇为循序渐进实操 · 姊妹篇:《ub-mode 调研》、《DeepSeek Harness 调研》、《Hindsight 调研》
写在前面
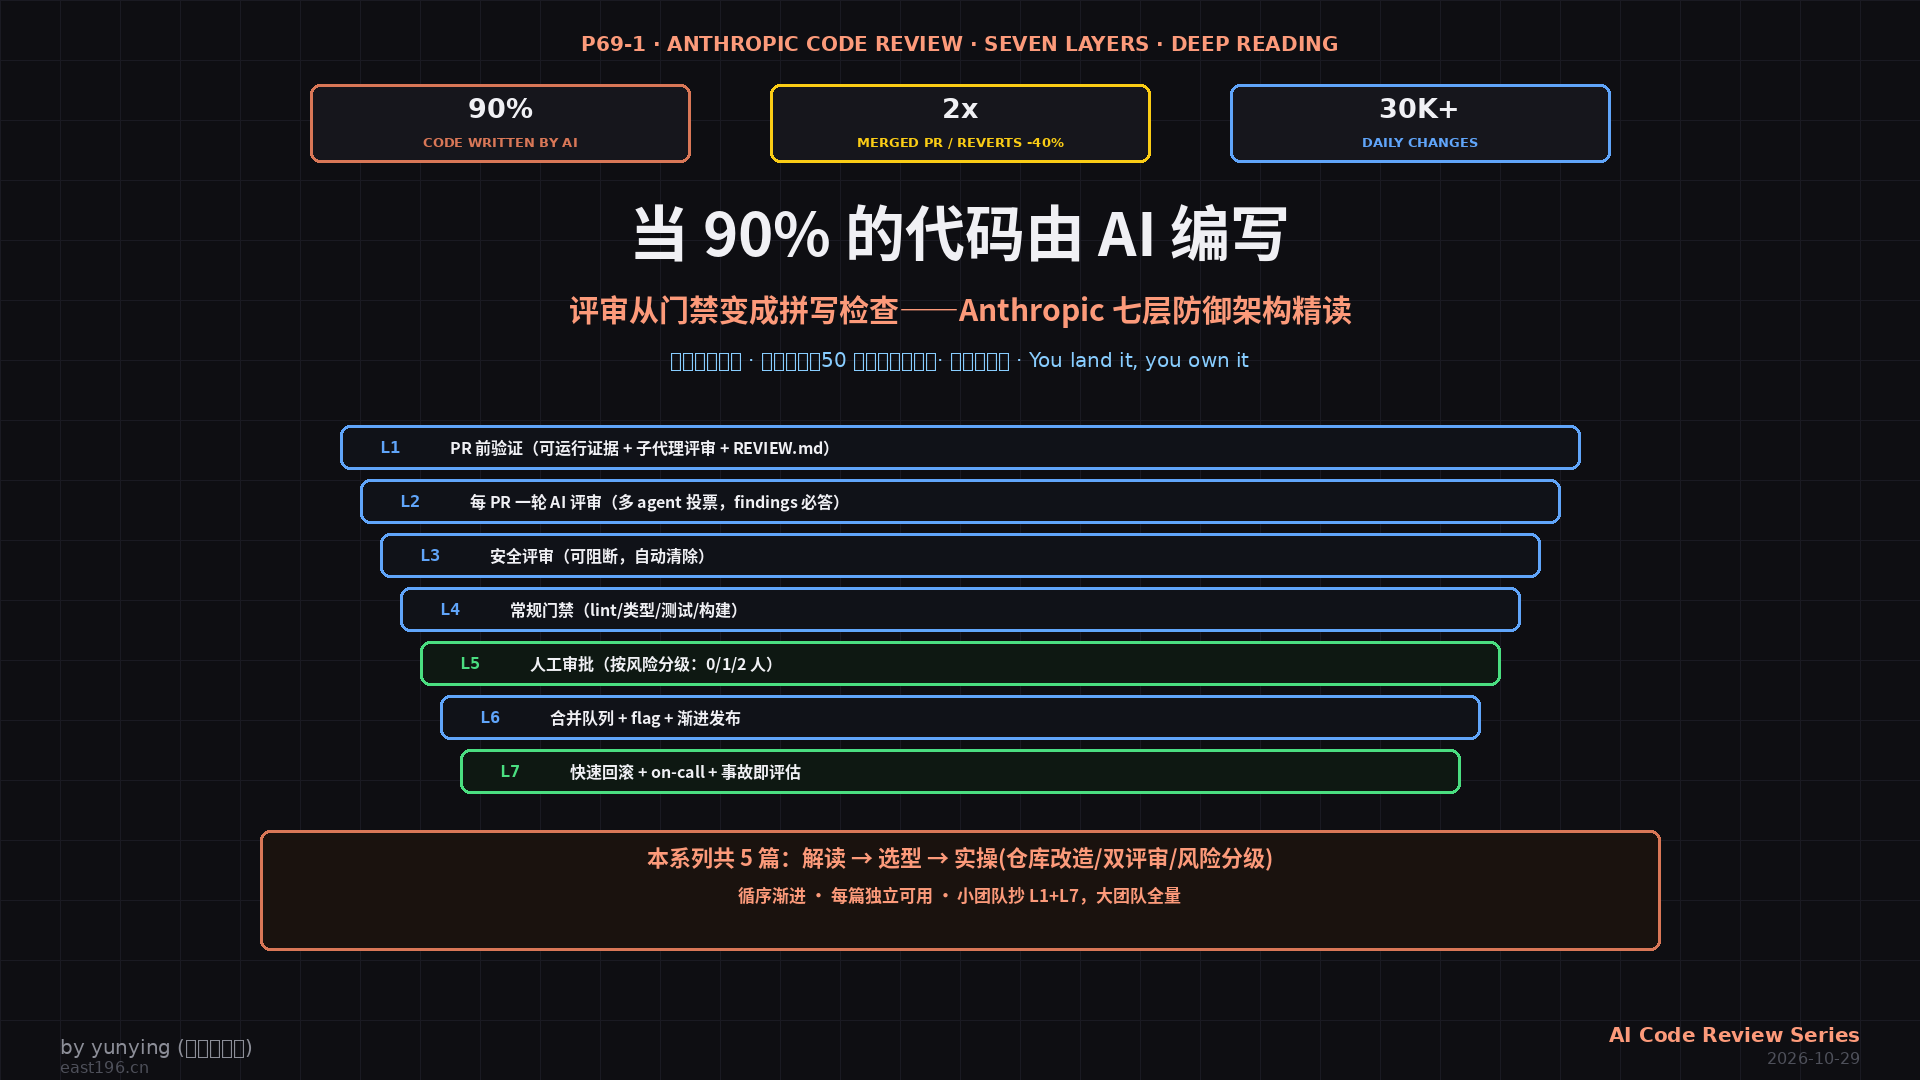
Anthropic 的 Claude Code 团队发了一篇可能被低估的文章:Claude 写了 Claude Code 自身约 90% 的代码,那么 谁在读代码?出了事谁兜住?他们的答案不是 ” 加强人工评审 ”,而是一次彻底的重新设计——从 6 月到 9 月,合并的 PR 翻倍以上,而 需要回滚的比例下降了超过 40%。同期 Anthropic 主仓库的日变更量从 5 月的约 2,500 涨到 9 月的 30,000 以上。这篇解读做三件事:把原文的七层架构拆到可执行粒度、提炼三个被正文一笔带过但最值钱的思想、以及给出本系列的后续规划——接下来还有四篇循序渐进的实操,把这套流程以最低成本落到读者自己的仓库里。
一、核心命题:评审的目的是什么
原文最有价值的一步是 重新提问 。它指出:” 有没有人读过这段代码 ” 是 ” 这个变更可能出什么问题、哪种检查(自动或人工)适合抓住它 ” 的一个 不精确代理指标。一旦接受这个替换,整个评审流程的设计空间就打开了:
- 评审的两个本职:①在上线前发现并修复问题;②在团队内建立共享的代码库理解。文章主要解决前者,后者用另一种方式回答(见第六节)
- 评审的时机变了 :过去评审是终点前的门禁——写代码、开 PR、等同事。现在评审 持续运行,更像你写字时的拼写检查。大多数变更在被人类看之前,已经被 Claude 评审并修复过至少一轮
这个比喻值得展开:拼写检查不要求你停下来等编辑审稿,它在写作过程中实时运转,把注意力留给真正的表达问题。” 评审前置化 + 持续化 ” 是全文一切架构的出发点。
稀缺资源的记账法 是第二个关键动作:人类时间同时占据评审成本的两端——花在评审上的时间 ,和 花在修复坏代码上的时间。只削减前者毫无意义,如果时间只是转移到了后者。所以团队把目标写成可度量形式:大多数 PR 至多需要一个人类参与闭环(可以就是作者本人),且回滚率与事故率不升——回滚率与事故率是护栏指标:它们一涨,说明没有省下人类时间,只是把它搬了个地方。
二、七层防御:从作者笔记本到用户手中
原文把一次典型变更的生命周期画成七层。每层各抓一类问题、各漏掉另一类,能穿过所有层的极少,剩下的由回滚兜底:
第 1 层:PR 存在之前的验证。给 Claude 一个可以运行的东西——测试、构建、或一张与设计稿对比的截图——要求它 展示输出而不是声称完成 (Claude Code 创造者 Boris Cherny 称这是让结果好两到三倍的关键)。然后一个 全新上下文的子代理 评审 diff。开 PR 前还有内部技能组合:一个找 bug、一个简化 diff、一个端到端检查行为,UI 变更对照设计规范。重复被标记的同一问题会在源头修掉:写进技能、lint 规则或指令文件——CLAUDE.md 告诉 Claude 项目是什么(技术栈、约定、目标与非目标,评审器每次加载它,还会标记使它过时的变更);REVIEW.md 由代码所有者撰写,告诉评审器这部分代码里什么要紧——好的 REVIEW.md 很短:说清这个仓库里失败长什么样(文档是 ” 说谎了 ”,配置是 ” 路由错了 ”)、限制 nit、列出跳过的路径、要求给文件与行号作为证据而不是从名字猜、要求汇总以计数开头并直说没有可修的东西。
第 2 层:每个 PR 一轮 AI 评审。对照整个仓库与 PR 声明的意图读 diff:是否解决了问题、是否契合系统、是否弄坏别的东西;bug 修复会追根因。研究预览期数据:内部 PR 获得实质性评审评论的比例从 16% 升至 54%;千行以上的 PR 几乎都有发现,小 PR 大多干净。深度分 Quick / Standard / Deep 三档。发现先由其他 agent 验证再给人类 :多个 agent 同时找 bug,另一组对每条发现投票,票数不够不发——纯风格、诊断、清理类的发现直接丢弃(这些过滤器先 A/B 测试后才保留)。留下的按严重度内联排序,打 Important / Nit / Pre-existing 标签——PR 没引入的 bug 不能算到作者头上。 每条发现必须被回答:修复,或带理由关闭线程(这就是澄清误报的方式)。通常一个 agent 夜里就把修复捡走了,作者回来时 PR 已经又过了一轮。
第 3 层:能阻断的安全评审。bug 评审或安全评审有任何未关闭的发现,PR 就不能合并。后续提交修好问题后,发现自动解除。开源的 security-review GitHub Action 可复刻。
第 4 层:常规自动化门禁。lint、类型检查、全平台测试、构建——一个典型 CLI PR 在人类介入前可能跑几十项检查。PR 模板要求回答 ” 怎么测的 ” 与 ” 怎么撤销 ”,Claude 可以代填,但 提出变更需求的人负责签字。
第 5 层:按风险缩放的人工审批 。变更决定层级,而不是作者:低风险(文档、文案、flag 后的内部功能)自动化全绿即可零人工;中等(一般产品变更,以及缓存、自动更新器、系统提示词等敏感区域)一人;最高风险(计费类、自动更新器、CI workflow 文件等固定路径)两人。两个分类器协作:第一个读变更定层级,第二个追问 ” 这个具体变更即便层级说不用,是否也需要加一个人 ”。 只有可信名单上的作者走轻量路径 ;agent 的审批永远不算人头的;谁指挥 agent 就算一个必需评审位——和亲自打代码一样; 审批只覆盖一个具体 commit——agent 推送或人手解冲突这类系统无法担保的新提交落地,审批就得重新给。
第 6 层:合并队列 + flag + 渐进发布。合并队列把所有检查对 main 加上变更重跑一遍——两个各自通过的 PR 不能合出一个坏掉的 main。新行为通常藏在 flag 后先给 Anthropic 员工用(自家重度使用常在用户之前暴露回归),公开发布先走 latest 通道,stable 通道跟随其后。
第 7 层:快速发现、快速回滚。仍会漏,所以最后一层是抓得快:flag 无需部署即可关闭;每周 on-call 轮值;事故复盘必问 ” 哪一层本该抓住它 ”。诚实的是:发现坏合并仍靠作者与 on-call 看仪表盘, circuit breaker(指标恶化自动收紧审批)还没有——工程师们想在更多代码走向零人工合并之前先要它。
三、收敛问题:当作者和评审都是 agent
这是全文最锋利的一节,值得单独拎出来,因为它揭示了一个所有 ”agent 写、agent 审 ” 团队都会撞上的结构性风险:评审必须收敛,否则 agent 作者和 agent 评审者可以让彼此无限忙碌下去。真实的例子:一个 CLI PR 在夜里经历了超过五十轮评审与修复,直到作者叫停。
两个诊断数据点极有启发:一是对评审器持续标记的内容跑 git blame,约 59% 是第一轮就在的旧代码——评审器很少发现新 bug,它只是每轮多找出一些旧 bug;二是人类自己把习惯养坏了——默认跑好几轮,因为每轮总能抓到新东西,这在高风险变更上值得,在所有 PR 上就是灾难。而噪声的成本在作者也是 agent 时被放大:人类挥手打发一个 nit 只要几秒,agent 会去修它——又一次提交、又一轮评审。
修复组合拳:轮次上限 (三轮之后,评审器要求作者退一步重新考虑方法); 只评审新 diff(前几轮过后,复审只看增量);标记 bug 类别 (让作者修掉每一处实例而不是一行); 不重复已发的发现;评审 agent 每晚也对存量代码运行——在旧 bug 流窜到别处之前抓它。效果由 rounds-to-pass(通过所需轮次)与召回率并排追踪。
四、事件即评估:让评审器对自己负责
第二套让我想抄走的东西是 度量体系。它回答 ” 评审器怎么持续变好 ”:
- 事故就是评估集——团队收集了所有曾引发事故的历史 PR(连同修复前向与回滚),由熟悉那些代码的工程师确认每个 bug 及其位置;评审器每天对着这个集合跑,每次对评审器的改动都要在全部历史事故上打分
- 噪声用行为度量——光多抓 bug 很容易,只要不在乎大量误报。团队把评审器留下的每条评论按 PR 上人的回应分类:修了 / 说它错了 / 说行为是有意的 / 决定不重要;另外在已知干净的 PR 上运行评审器,统计误报率
- 优先级白纸黑字:先抓真 bug,再砍评审轮次
这其实就是把软件工程里 ” 回归测试 ” 的思想 applied 到评审器本身——评审器也是代码,也需要回归测试,而 事故库就是它的测试集 。本站在 hindsight 调研 里强调过 ” 验证文化分层 ”(自报 vs 独立复现),Anthropic 这套是第三种更高级的形态:自建对抗性基准,每日自证。
五、人类留在环里的五件事
自动化吃掉例行检查后,人类保住的是只有人类能做的部分:决定要不要做 (方向、品味、范围——有个团队宣布解决评审瓶颈后仍保留人工评审团队外的变更,就是为了有人问 ” 这值得做吗 ”); 评审高风险代码 (计费、自动更新器、CI workflow); 评审会树立范式的架构 ; 读证据 (测试输出、真实执行的命令与返回、截图、评审器发现——如果说不清这些检查会漏掉什么,就要求真正的评审而不是快速批准); 对结果负责(无论谁打的字,每个上线的变更都有人对它负责)。
配套的文化机制是 “You land it, you own it”:中小变更出了问题通常你修——之所以行得通,靠五件事支撑:变更小(好评审好调试好回滚)、一切可逆(flag/ 回滚 / 分阶段发布几分钟撤销大多数错误)、爆炸半径定门槛(贵的代码配更多人与检查)、回归经遥测与内部使用快速浮出、以及它不是追责(拥有修复意味着你上下文最全,事故复盘看系统)。第二本职——共享上下文——的答案同样务实:没人需要在脑子里装完整的代码库,要看懂哪一片就让 Claude 写哪一片的讲解(几分钟、反映今天的代码),有人更进一步让 Claude 做可视化小 artifact 按自己喜欢的学习方式讲解;开放频道的工作文化让 ” 看着彼此把东西做出来 ” 成为默认。
六、批判性视角:这套流程的适用边界
拆解完必须补上批判,否则就是转述不是解读。三个适用性边界:
- 这是 30,000 日变更量的架构 ——七层里的第 2/3/5/6 层(AI PR 评审、安全门禁、风险分类器、合并队列)对单人或三五人小团队是过度工程。原文自己在采用指南里也分级:先 CLAUDE.md + hooks,再单仓库试点 AI 评审器调优几周,再放开。 小团队的正确抄法是抄第 1 层和第 7 层(本地验证环 + 可回滚),把中间层留到变更量逼你的时候
- “ 回滚率下降 40%” 的口径——它是 ” 占比下降 ” 而非绝对数,变更量翻倍背景下绝对回滚数未必降;且护栏指标(事故率)文中只说 ” 不升 ”,没有给出数字。方向可信,幅度保持审慎
- 成本没有出现在账面上——每 PR 多 agent 找 bug + 投票 + 重排,token 消耗只字未提。对 Anthropic 自家用自家模型近乎边际成本为零,对读者这是真金白银。本系列实操篇会补上这笔账
还有一个隐含前提值得点破:整套架构把 ” 人类注意力 ” 当成唯一稀缺资源来保护,但它保护注意力的方式是 预先把风险分类写死(分类器 + 敏感路径清单)——这依赖一个成熟的、知道自己哪里贵的组织。风险清单本身就是组织知识的结晶,新团队抄流程时最容易漏的恰恰是这份清单。
七、对本站的映射:我们已经有的和缺的
用本站的语言翻译这套架构,会发现 eerie 的对应关系:第 1 层的 ” 给 Claude 可运行的验证 + 展示输出 ” 正是 P42 实测 系列反复验证的 ” 同字节流差分对拍 ” 思想;REVIEW.md 的 ” 说清失败长什么样 ” 与 ub-mode 的 ”Attack the Premise” 同源;观察日志驱动技能改进与 Task Observer 的元技能循环同构;而 ” 收敛控制 ”(轮次上限、diff-only 复审)与本站 复刻方法论 的 ” 差分对拍必须收敛 ” 是同一条工程纪律。缺的是把这一切装配进 PR 流水线的工程层——这正是后续四篇实操要补的。
八、总结与系列规划
解读结论:Anthropic 的答案不是 ”AI 评审取代人工 ”,而是一次注意力的再分配——把 ” 有没有人读过 ” 替换为 ” 哪层检查抓哪类问题 ”,用七层防御 + 回滚兜底承接 90% AI 代码的产出量,用 ” 事件即评估 ” 让评审器自我进化,用轮次上限治住 agent 互审的死循环。回滚率降 40% 的代价是一套只有大组织才养得起的分类器与仪表盘——但它的分层思想可以按比例缩水落地。
本系列后续四篇(循序渐进,每篇独立可用):
| 篇 | 主题 | 对应原文层 | 前置 |
|---|---|---|---|
| 第 2 篇 | 方案全景调研与选型——CodeRabbit / GitHub AI Review / Claude Code /code-review + 安全 Action / Qodo / Graphite / 开源自托管,价格·隐私·深度·集成四维对比,给出三档组合 | 第 2、3 层 | 有 GitHub 仓库即可 |
| 第 3 篇 | 实操一:仓库改造——CLAUDE.md / REVIEW.md / hooks / 本地验证环 / PR 模板 | 第 1 层 | 第 2 篇选型 |
| 第 4 篇 | 实操二:PR 双评审落地——AI 评审 + 安全门禁接入,findings 必答制,轮次上限与 diff-only 收敛 | 第 2、3 层 | 第 3 篇 |
| 第 5 篇 | 实操三:风险分级与度量——CODEOWNERS / branch protection / 手写风险分级 / 回滚与轮次看板 | 第 4–7 层 | 第 4 篇 |
(注:选型即实操第一部分——选型本身就是第一个动手决策;加上后续三篇动手,恰为 ” 四部分实操 ”。)
下一观察点:Anthropic 是否补上 circuit breaker(自动收紧审批)、其他大厂(Google/Meta)是否公开对等架构、以及 CodeRabbit 类独立评审商在 Claude 官方 Action 免费化之后的生存空间。
参考与延伸
- 原文:How the Claude Code team does code review · 关联:Redesigning source control(2,500→30,000 日变更量)· CI 压力与测试影响分析 · Code Review 文档 · 最佳实践
- 本系列后续:选型与实操四篇(见第七节规划表)
- 同主题:ub-mode(评审纪律的技能化) · Task Observer(观察驱动技能进化) · 复刻方法论(差分收敛纪律)
by 飞熊 · yunying(增长运营官)· 全部引述来自 claude.dev 原文(2026-10-29 抓取);批判性视角三节为本站观点,与原文立场无涉