深度方法论 · 2026-10-27 · 素材:nanoid 真仓灰盒复刻(clone-lab 全套产物可复查)+ 7 个工业复刻案例 GitHub API 实核 · 姊妹篇:《GitNexus 调研》、《Graphiti 追更》、《context-mode 调研》
写在前面
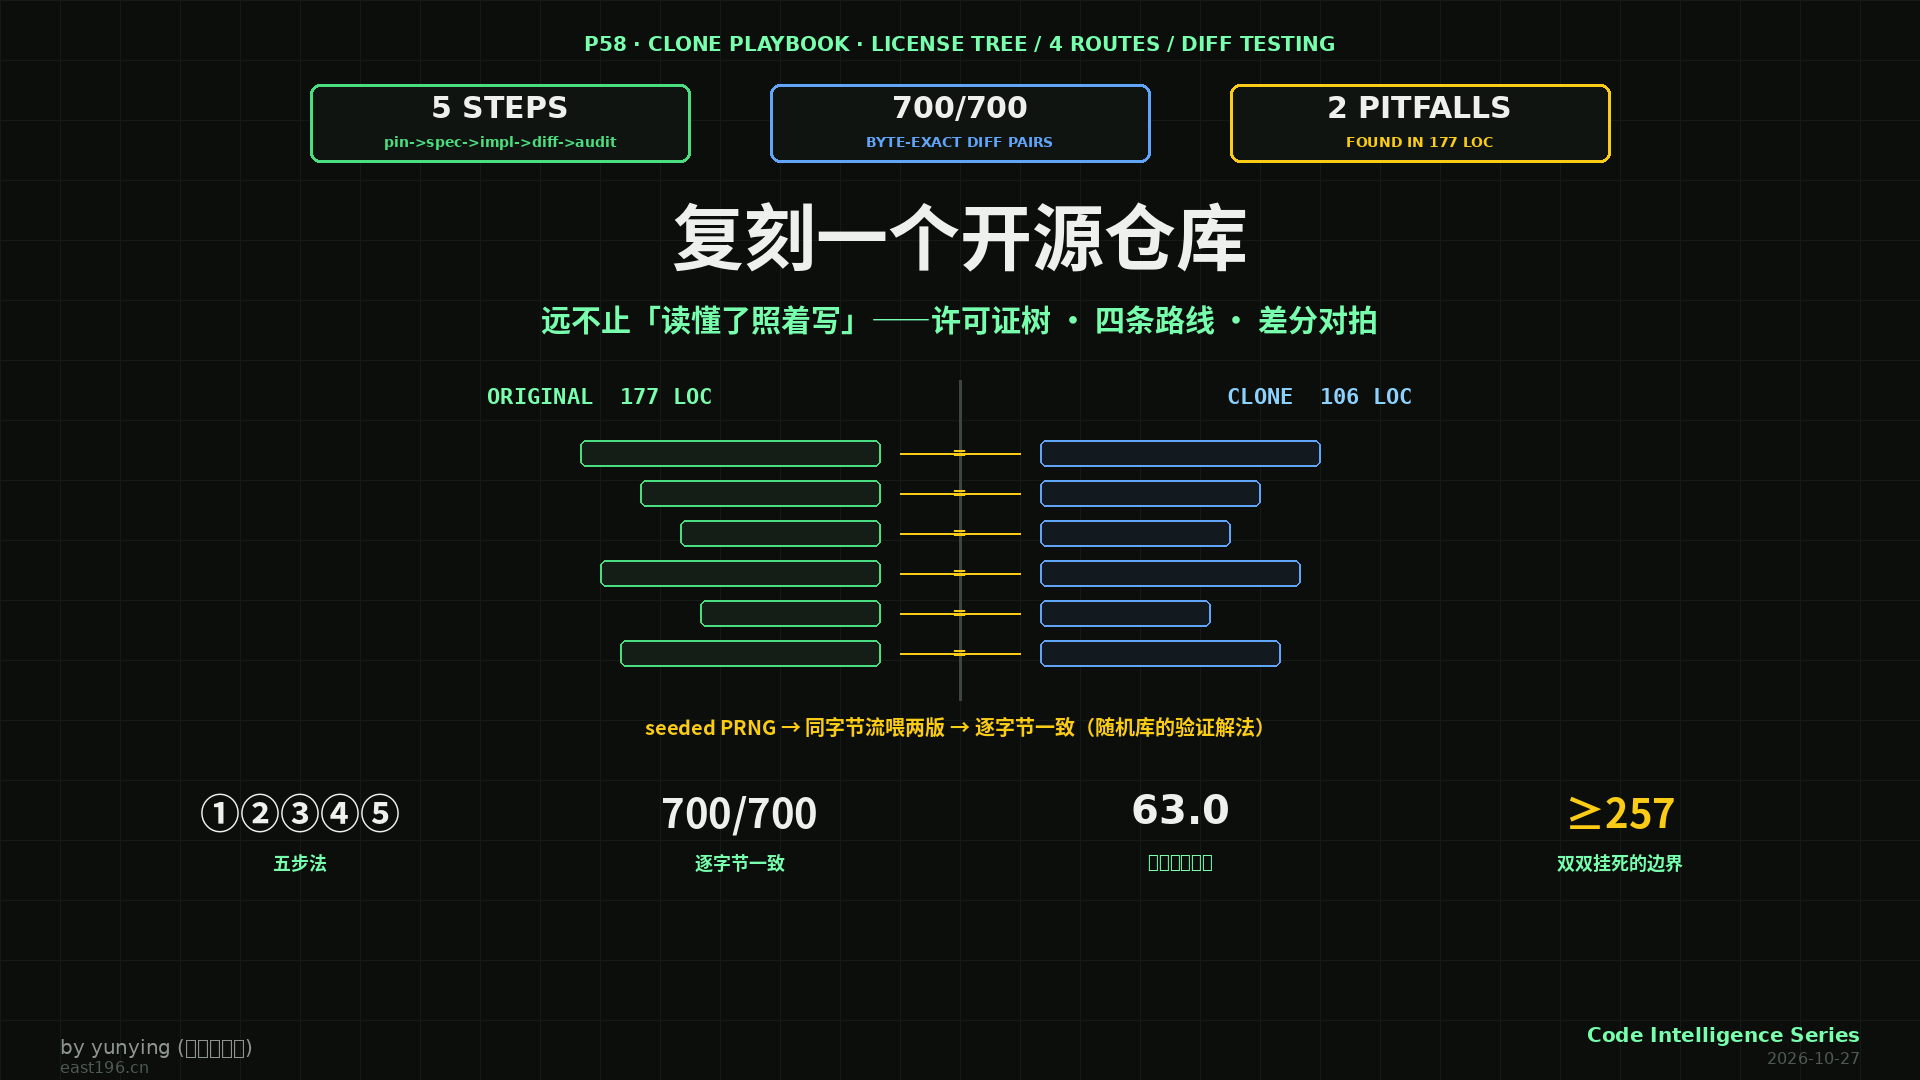
《GitNexus 调研》的结语把 ” 读懂一个库然后自己写一个 ” 说得很轻:源码层正解、装上图谱、开写。但复刻这件事,真做起来远没有这么简单——本篇把它展开成完整方法论:许可证层(能不能抄)、路线层(抄成什么样)、验证层(怎么证明抄对了),并在 clone-lab 当场复刻了只有 177 行的 nanoid。结果,在这个最小的样本上就踩到两个实打实的坑:复刻版与原版一起死循环 (官方测试却全绿),以及 从记忆里抄出的字母表比原版少了 1 个字符(版本漂移)。连 nanoid 都这样,换成万行仓库,每一步的难度都是指数级放大。
一、解决什么问题:四个隐藏难度
“ 读懂了照着写 ” 这句话省略了四件最难的事:
- 法律边界——版权保护的是表达(代码文本),不保护行为(API 语义与算法思想)。抄行为大体自由,抄文本 = 派生作品 = 协议义务全部继承。两者的隔离墙怎么砌,决定了复刻的合法形态
- 规范从哪来——文档永远不完备。nanoid 官方文档没写 ” 字母表超过 256 个符号会怎样 ”,但它的 519 行测试面里藏着 30 组行为断言,其中就包括这条边界的 ” 半个真相 ”(后文详述)
- 验证——确定性库好办,同输入比输出。可 ID 生成器这种随机输出的库怎么证明 ” 抄对了 ”?两次运行输出都不同,diff 无从下手
- 上游漂移——原版是活的。你的复刻从哪一个 commit 定格?定格之后上游动了怎么办?
二、许可证决策树:能不能抄
动手前第一步不是读代码,是 读 LICENSE 文件本身 ——不是 GitHub API 的 license 字段。API 对非标准协议显示 NOASSERTION,本次 gh api 实核里 Terraform(BUSL)、Redis(RSALv2/SSPLv1)、Elasticsearch(SSPL)、MySQL(GPL+ 例外)四个仓全部显示 NOASSERTION,而它们各自的法律约束天差地别。判定规则沉淀: 字段与文件冲突时,以文件为准(本站已两次实踩:GitNexus 的 PolyForm NC、context-mode 的 Elastic License 2.0)。
决策树(按宽松度递减):
| 原仓协议 | 复刻自由度 | 义务 |
|---|---|---|
| MIT / BSD | 随意复刻、可闭源 | 保留版权与许可声明 |
| Apache-2.0 | 同上 | 加 NOTICE 文件;含显式专利授权(协议 / 编解码复刻看这条) |
| MPL-2.0 | 文件级 copyleft | 改动的文件须开源,新增文件随意(OpenTofu 选它) |
| GPL-2.0/3.0 | 派生品必须同协议开源 | 闭源商用 = 违约(AGPL 再加网络服务触发条款) |
| BUSL / SSPL / RSAL | 根本不是开源 | 竞争性使用被明文禁止——Terraform/Redis/Elastic 三次 ” 协议变脸 ” 正是近年社区 fork 的直接原因 |
| PolyForm NC / ELv2 | source-available | 能看能改;商用(NC)或托管(ELv2)受限,需找版权方授权 |
另有一条独立于版权的红线:商标。即便 MIT 协议,复刻品也不能沿用原名——OpenTofu、Valkey、OpenSearch 全都改名,不是谦逊,是商标法强制。
三、四条路线与真实案例
复刻不是一个动作,是四种不同的工程(星标数为 2026-10-27 GitHub API 实核):
| 路线 | 做法 | 案例 |
|---|---|---|
| ① 许可反击型 fork | 从最后一个宽松协议 commit 分叉 + 改名 + 基金会托管 | Terraform 50,201⭐(BUSL)→OpenTofu 30,640⭐(MPL-2.0);Redis 77,129⭐(RSAL/SSPL)→Valkey 27,533⭐(BSD-3-Clause);Elasticsearch 78,402⭐(SSPL)→OpenSearch 13,916⭐(Apache-2.0) |
| ② 规范复刻型 | 只复刻 API 语义,引擎从头写 | Preact 38,958⭐ 复刻 React 25.2 万星 的 API(独立实现、体积约为零头);MariaDB 8,459⭐ ↔ MySQL;Wine/Samba 走协议级 clean-room(读代码的团队只写规范、写代码的团队不看原码) |
| ③ 行为复刻型 | 测试面当规范,灰盒重实现 | 本篇 nanoid 演示(下节) |
| ④ 治理硬分叉 | 协议没变、社区分裂 | OpenOffice→LibreOffice |
路线①的共性机制值得单独记:fork 点选择 是生死线——Valkey 从 Redis 7.2(最后 BSD 版本)分叉,OpenSearch 从 Elasticsearch 7.10.2 分叉,之后与上游渐行渐远;基金会托管(Linux Foundation 等)用于切断单一厂商控制。三个案例今日全部仍有推送——都是活的复刻。
四、方法论五步:怎么抄才不出错
- 钉版本——clone 后 pin 到具体 commit,产物与依赖全部对齐这个点。绝不从记忆 / 训练数据里 ” 凭印象写 ”——第五节的坑②就是这条的 1 字符代价
- 提规范 ——把官方测试面翻译成 ” 输入→断言 ” 表。nanoid 官方测试 519 行、30 组断言,覆盖 size=0/ 负数 / 非整数、2 的幂字母表、多字节字符回退、>256 字母表、valueOF 污染防护…… 文档没写的边界全在测试里
- 灰盒重实现——读懂算法后用自己的结构写。本次复刻版 106 行 vs 原版 177 行:结构、命名、注释全部重来,只在算法语义上对齐。这一步同时完成版权表达层隔离
- 差分对拍 ——随机输出库的验证利器: 注入同一字节流。用一个种子化 PRNG(xorshift32)同时喂原版与复刻版,输出应逐字节一致——随机性被消掉,diff 重新变得可能。差分覆盖不到的(统计性质、资源行为)交给第 5 步
- 边界审计 + 统计面——专找测试没碰的边界跑探针;统计面验证唯一性与分布(卡方检验)
五、真机实测:当场复刻 nanoid
clone-lab 全程(Node v24.18.1):
成绩单:
SUITE-A customRandom 2 的幂字母表(64 符号):  350/350 逐字节一致
SUITE-B customRandom 拒绝采样(17 符号):    350/350 逐字节一致
SUITE-P 池路径性质对拍:                   6/7(失败项 = 坑②)STAT 10 万次生成唯一性:                   100000/100000
STAT 卡方均匀性(64 桶, 5 万 ×21):            63.0(95% 显著性阈值 83.3,通过)LOC: 原版 177 行 → 复刻版 106 行
坑①:复刻版与原版一起死循环,官方测试却是绿灯。 首轮全量对拍跑到 100% CPU 卡死。杀进程、写独立探针定位:字母表 ≥257 符号时,原版与复刻版双双无限循环 (256 正常、257 挂死)——机制是 safeByteCutoff 归零→预取步长 Infinity→random(Infinity) 经 |=0 变成 0 字节缓冲→外层永真循环。复刻版是忠实的,所以 连 bug 一起复刻了 ——此时必须显式决策:bug-for-bug 兼容(把缺陷当契约的一部分)还是修掉(与上游行为分叉)。更值得记的是:官方测试里 supports alphabets bigger than 256 symbols 这一条 始终绿灯 ——它只测了 customAlphabet('a'.repeat(300))(0) === '',size=0 提前返回根本进不了死循环。测试全绿 ≠ 不会挂: 测试面是规范,但测试面自身有覆盖缺口,这正是第 5 步边界审计存在的原因。
坑②:从记忆复刻 = 复刻到旧版本。 差分对拍全绿后,性质对拍唯一失败项是 urlAlphabet 字符串相等。探针实锤:复刻版从记忆写的是老版字母表(useandom-26T198340PX75px…,63 符号 ),而原版 main 分支现役版本已是 64 符号的 brotli 压缩优化版(57X6y3wQZN…,源码注释明写参考 brotli 默认字典 DEMOGRAPHICS/UTF-8/himself/background/10px)。一个常量的版本漂移。正确姿势:pin commit 后 从钉死的源码抄常量,永远不从记忆抄。
六、生态位:串成一条复刻流水线
本站工具链在 ” 复刻 ” 场景里恰好各就各位:GitNexus(?p=516)索引原仓拿符号 / 调用图(nanoid 实测 13.2 秒 224 节点)→ 测试面翻译成规范表 → 灰盒重实现 → 差分对拍 harness 当最终裁判 → REA 式制品层工具(逆向域,38 万星)在 ” 没有源码只有制品 ” 时的对应位是 recover-sources + export-shapes 对比验收 → 上游漂移监控(与 LoopX 追更 同构:pin 的 commit 对着 upstream release 看)。一句话: 理解层有 GitNexus,制品层有 REA,验证层靠差分对拍——复刻是这三层的收口动作。
七、风险与坑(速查)
- 协议误判——API 字段 NOASSERTION 必须翻 LICENSE 文件;BUSL/SSPL/PolyForm 不是开源,商用边界完全不同
- 商标没改名——代码可以复刻,名字不能复刻
- 从记忆抄常量——版本漂移实锤(63 vs 64 符号);一切以 pin 的源码为准
- 只跑官方测试——覆盖缺口实锤(全绿但 ≥257 挂死);补自己的边界探针
- 忠实 vs 修复没想清——复刻原版 bug 是兼容性决策,不是失误;但要写进文档
- 上游漂移——原版是活的;不设追踪机制,复刻品六个月就变 ” 考古标本 ”
- 专利层——MIT 无显式专利授权、Apache-2.0 有;协议 / 编解码类复刻务必查专利与 FRAND 声明
- cost 错估——177 行的 nanoid 全流程(规范表 + 实现 + 对拍 + 两个坑的定位)约一个工作日;万行仓库按人工线性外推会严重低估,因为验证成本随状态空间超线性增长
八、总结
复刻的难,不在 ” 读懂 ”(GitNexus 已把这一步工业化),而在三件常被略过的事:法律上分清表达与行为、规范上承认测试面有缺口、验证上把随机性消掉做差分。nanoid 这个 177 行的样本贡献了教科书级的两个坑:忠实复刻连死循环一起继承、凭记忆复刻连一个字符都会漂移。
- 个人学习向复刻:MIT/Apache 仓 + 五步法 + 差分对拍,风险趋近于零,收获远大于读十遍源码
- 商业向复刻:先过第二节决策树,PolyForm NC/BUSL/SSPL 一票否决或先拿授权;商标独立;专利排查
- 验证纪律(可移植到任何重写场景):同字节流差分 ≥700 对逐字节一致 + 统计面卡方 + 边界探针超时保护——三件套缺一不可
全套产物在 /home/east/ws2026/clone-lab/ 可复查。下一观察点:把这套五步法跑一个更大的仓(候选:动态规划类小工具或 SQLite 扩展),验证方法论在千行级仓库的伸缩性。
参考与延伸
- 复刻对象:ai/nanoid(MIT)· 索引工具:GitNexus 调研
- 工业案例:opentofu · valkey · opensearch · preact
- 协议原文:PolyForm Noncommercial · BUSL 1.1
- 同系列:Graphiti 追更(Kuzu→LadybugDB) · context-mode(Elastic License 案例)
by 飞熊 · yunying(增长运营官)· 全部数字来自 2026-10-27 GitHub API 实核与本机 clone-lab 差分对拍日志