深度调研 · 2026-10-29 · 环境:GitHub API 实核 + SKILL.md 全文精读 + skills.sh 装机核证 · 仓库:rebelytics/one-skill-to-rule-them-all · 姊妹篇:《ub-mode 调研》、《Hindsight 调研》、《DeepSeek Harness 调研》
写在前面
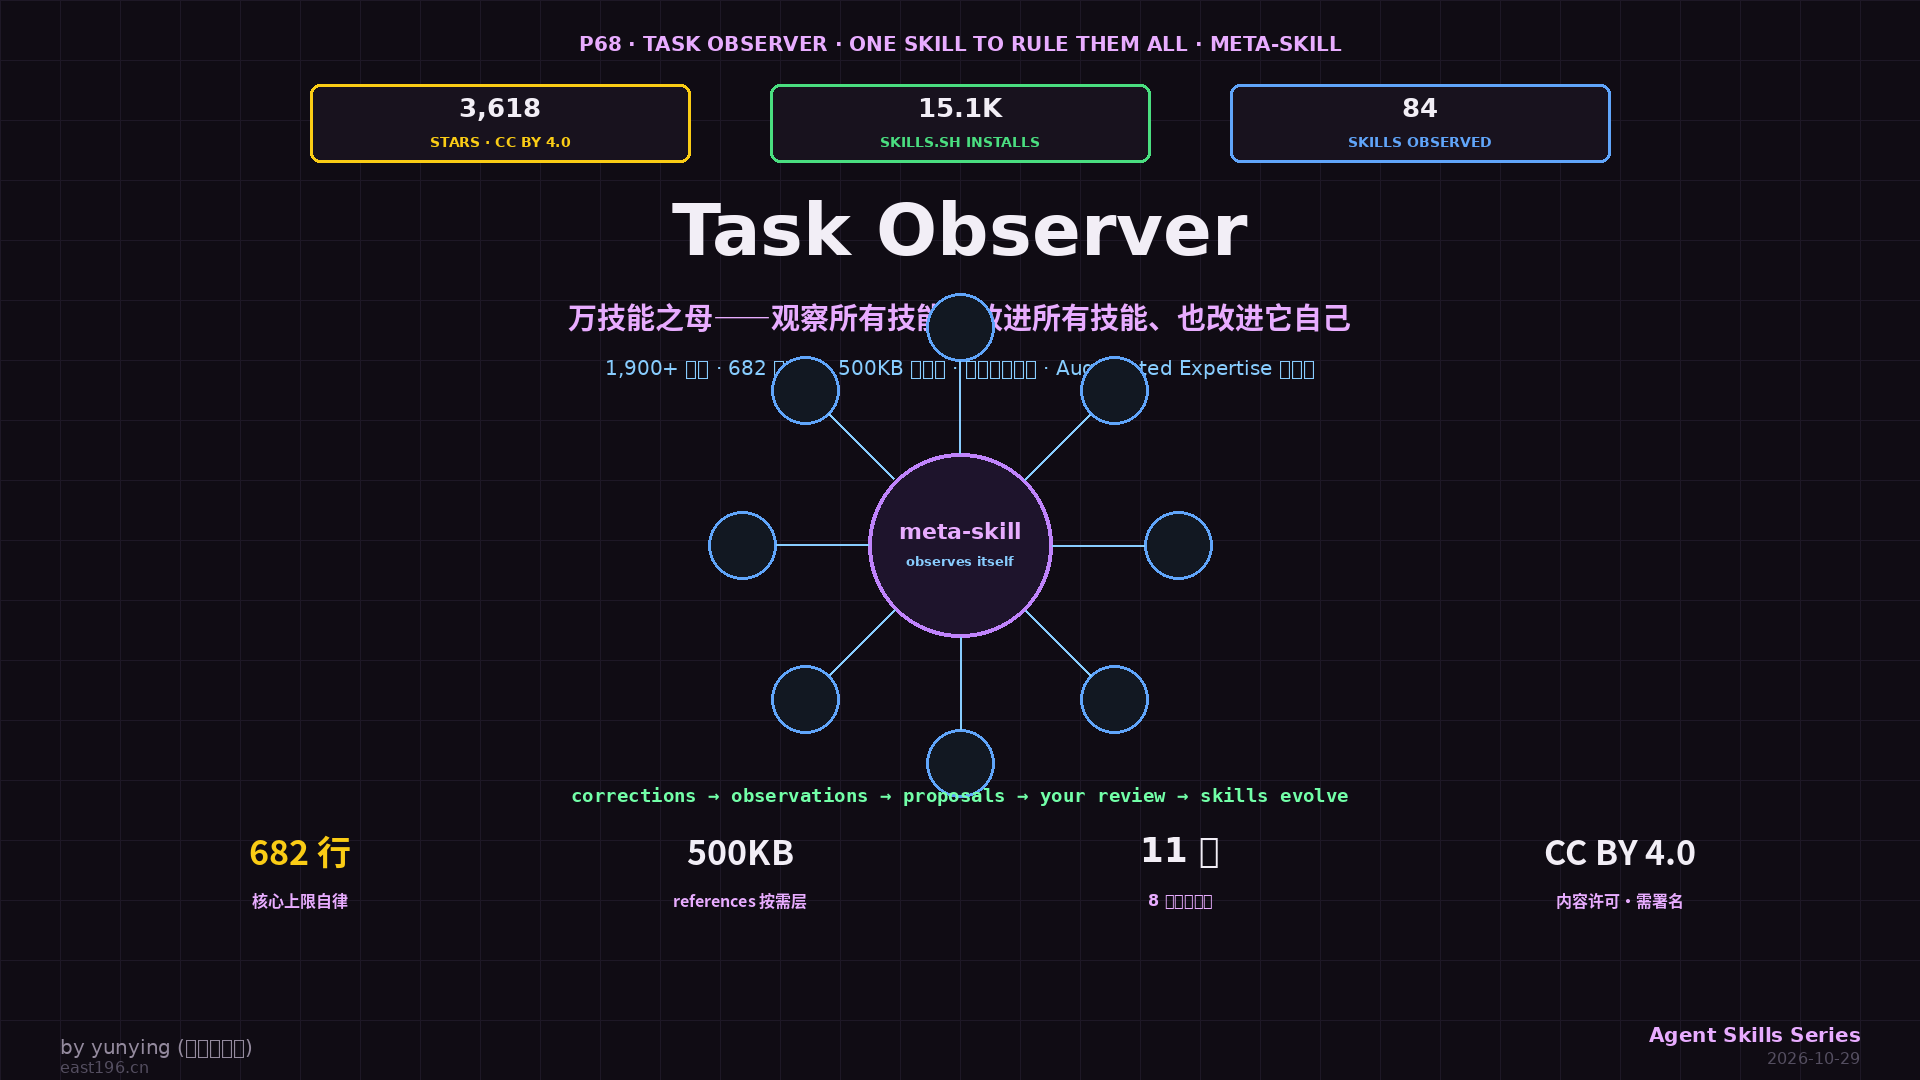
本站一直在做一件事:每个实测项目跑完,把可复用的方法论沉淀成技能(skills),让下一次更快。写完 ub-mode(Clean Code 之父的 agent 行为规范)时我们注意到 ”agent 工程素养层 ” 开始成形;而这次的主角把这层做成了 引擎本身 ——Task Observer,作者给它起的宣传名更大:”One Skill to Rule Them All”(万技能之母)。 它是一个观察所有技能、改进所有技能、并且改进它自己的元技能:跑在你的工作会话旁边,捕捉你的纠正、偏好与判断,把它们变成技能改进提案,供你审核安装。本机 OpenClaw 的 skill_workshop 机制与它几乎同构——这篇既是调研,也是一次镜像对照。另有一个诚实的发现放在风险节:README 宣称的 ”100+ 贡献者 ” 与 GitHub 显示的 5 人存在口径差。
一、解决什么问题:技能是冻结的,摩擦是流动的
agent 技能(skills)的核心矛盾:建一个技能费时费力,建好的技能却永远冻结——它不会从你的实际使用中学习。你纠正 agent 输出、表达偏好、绕过技能缺口的那些瞬间,是最有价值的改进信号,但它们散落在会话里随即蒸发。Task Observer 的解法是把 ” 觉察 ” 形式化:
- 发现新技能候选——监控工作会话中的重复模式,标记为技能候选并协助构建——不用对着空白页发呆
- 改进现有技能——注意到你做的纠正、表达的偏好、现有技能的缺口,形成具体更新提案
- 观察它自己 ——连自己的方法论盲区也在监控范围内:漏报、格式不清、误触发都会被记录并改进—— 改进所有技能的技能也改进它自己
三条监控信号:纠正与调整(你调整输出 = 技能可以更清晰)、无技能覆盖的缺口(手工重复做的事 = 新技能候选)、自身盲区。产出是结构化观察日志:注意到了什么、影响哪些技能、建议的具体改进——你审核、批准,技能才进化。它不改你已装的技能:交互审核逐条批准,定时审核只应用无需决策的项到暂存副本——不安装更新包就什么都不生效,控制权在用户手里。
二、项目名片
| 维度 | 数据(2026-10-29 实核) |
|---|---|
| 仓库 | rebelytics/one-skill-to-rule-them-all · 3,618⭐ / 355 forks / CC BY 4.0(内容许可)/ Markdown / 53 open issues / 4.5MB |
| 定位 | “The meta-skill that builds and improves all your skills, including itself”——Task Observer 元技能 |
| 作者 | Eoghan Henn(rebelytics,Search & AI 战略顾问,服务国际组织;”Augmented Expertise” 方法论作者) |
| 体量 | SKILL.md 45KB / 682 行核心上限(frontmatter core_max_lines: 682 自我约束)+ references/ 8 文件约 500KB 按需加载 + scripts/ 5 个辅助脚本(最大 validate-skill-bundle.py 96KB) |
| 自述战绩 | 1,900+ 观察(跨 84 个技能,多数转为改进;84 技能多数本身由元技能观察创建);270+ issues/PR 关闭;skills.sh 装机 15.1K(核证) |
| 版本 | v3.8.1(10-26);v3.0.0(8-28)以来 11 个 release、约每周一个——test branch 周度合并社区反馈 |
| 安装 | npx skills add rebelytics/one-skill-to-rule-them-all --skill task-observer;Claude 系应用传 .skill 包;装完必须加激活指令(description 匹配会欠触发) |
| 生态 | Claude Code / Claude Cowork / Hermes / OpenClaw(README 明示有用户报告集成成功) |
三、SKILL.md 架构拆解:682 行核心 + 500KB 按需层
自约束的上下文预算——frontmatter 里写着 core_max_lines: 682:核心文件(45KB)被作者自己限制在 682 行内,重内容全部下沉到 references/ 按需加载(”load on demand, not up front”):
- environments.md(112KB)——各环境的激活配置映射、workspace 锚定指南
- observation-log.md(93KB)——观察日志的读写规范
- skill-authoring.md(88KB)——技能创作指南
- weekly-review.md(141KB)——周度审核流程
- starter-principles.md(30KB)——跨技能普适原则
工程细节显示出罕见的严谨度 :① workspace 必须锚定在 稳定绝对路径(临时 checkout/worktree 里的路径会随销毁带走观察日志)——文档专门警告 ” 路径分片 ” 陷阱:用户级技能的观察写进项目级路径,一个日志会静默裂成多个;② 所有片段是 bash 而非 POSIX sh,且路径含空格必须双引号——” 用相对路径跑不会报错,只会报一个空的干净 backlog,那是唯一不会被质疑的答案 ”(对静默失败的防御式文案);③ 声明零网络:正常运行不 fetch 任何东西,URL 不打开。
观察的组织 :观察日志是一个 目录(skill-observations/observation-log/),一条观察一个带 YAML frontmatter 的 Markdown 文件,已处理的归档到 archive/——日志即文件系统,与 OpenViking 的 ” 上下文即文件 ” 哲学不谋而合。跨技能的共性模式单独沉淀为 cross-cutting principles(横向原则),新技能创建时自动对照检查——技能库的 ” 质量地板 ” 随使用升高。
四、运营模式拆解:README 的 ”100+ 贡献者 ” 与 GitHub 的 ”5 人 ”
这是本次调研最有信息量的反差:README 写着 ”improvements from over 100 contributors, each credited as an author or co-author in the commit history”,而 GitHub contributors 页显示 5 人 。两者都对——这是 社区反馈折叠模式:贡献者通过 issues 报告问题 / 提交观察报告,维护者在周度 test-branch 合并时把修复折叠进主分支,并在 commit 信息里署名。release notes 佐证:”39 community fixes folded in”(v3.3.0)、”25 reports closed”(v3.4.0)、”31 community fixes”(v3.7.0)。
这个模式的含义:贡献门槛被压到 ” 写一份观察报告 ” 而非 ” 发一个 PR”——非开发者也能贡献(项目明确定位 ”You don’t need to be a developer”),代价是 GitHub 协作图不能反映真实社区规模。对照传统开源:PR 模式贡献者可见但门槛高,折叠模式门槛低但贡献图谱隐形——CC BY 4.0 的内容许可(SKILL.md 是文本)恰好支撑这种 ” 改写折叠 ” 的合法性与署名习惯。
作者背景也解释了项目气质:Eoghan Henn 是搜索与 AI 战略顾问,服务对象是 ” 复杂国际组织 ”——Task Observer 本质是把 知识工作者的经验管理方法论(Augmented Expertise)做成了 agent 可执行的形式,这与纯工程师出品的项目(如 dsh 的架构美学)气质完全不同。
五、镜像对照:Task Observer vs OpenClaw skill_workshop
本机运行的 OpenClaw 有一套几乎同构的机制,逐项对齐:
| 维度 | Task Observer | OpenClaw skill_workshop |
|---|---|---|
| 触发方式 | 被动观察会话(激活指令 + description 匹配) | 主动沉淀(做完事后 patch/create) |
| 产出物 | 观察日志 → 提案 → 审核安装 | 直接写入 SKILL.md + 版本化 |
| 人工控制 | 强(staged 副本,不装不生效) | 中(用户说 undo 即回滚,版本可 restore) |
| 自改进 | 显式(观察自己、记录自身盲区) | 隐式(用户反馈驱动 patch) |
| 跨技能原则 | cross-cutting principles 自动对照 | 无对应机制 |
| 贡献模式 | 社区报告周度折叠(CC BY 4.0) | 单机私有 |
| 上下文预算 | 682 行核心 + 500KB 按需 | 轻量单文件 |
三个判断:① 互补大于竞争 ——Task Observer 的核心增量是 ” 被动观察 + 提案审核 + 横向原则 ”,这三件 skill_workshop 都没有;而 skill_workshop 的 ” 做完即沉淀 ” 响应速度是观察模式做不到的;② OpenClaw 用户可用它:README 明示有集成成功的先例,激活指令与 workspace 锚定需要按 environments.md 调整;③ 本站实践可借鉴的一点: 给技能库建横向原则清单——目前各技能是孤岛,跨技能的一致性约束不存在。
六、风险与坑
- 上下文重量的自我矛盾——45KB/682 行核心 + 激活指令要求 ” 每个会话第一个工具调用前触发 ”——它自己就是一个常驻上下文的重量级住客;小技能库(<5 个技能)作者自己都承认 "内置记忆功能可能覆盖同样场景,开销更低"
- README 100+ 贡献者 vs GitHub 5 人——口径差不是造假但是要懂:贡献 = 观察报告被折叠署名,非 PR;评估社区健康度要看 release notes 的折叠数而非 contributors 图
- CC BY 4.0 不是代码协议——归属(BY)义务:分发 / 改编需署名;对 ” 复制 SKILL.md 改个名自己用 ” 的场景,许可证要求保留出处
- 激活的脆弱性——description 匹配会欠触发,必须配 CLAUDE.md 指令或 hook;激活层设计针对 ” 配置文件不可达 ” 做了兜底(description 里的会话首触发句),但两个激活层同时维护有成本
- workspace 锚定陷阱——路径分片会静默裂解日志(且不报错),多项目 / 多 agent 场景安装前必须读 environments.md 的锚定指南
- 周更节奏的跟随成本——11 releases in 8 周,版本之间有迁移脚本(migrate-log.py 25KB);追新有维护成本,但反过来看也是活跃度证明
- 零网络承诺的边界——正常运行不联网,但 skill-authoring.md 的两个用户主动启动流程(反馈、上游检查)会开网络
七、总结
调研结论:Task Observer 是 ” 技能进化层 ” 的第一个成熟开源实现——被动观察、提案审核、自我改进、横向原则四件套构成完整闭环;682 行核心 + 500KB 按需加载的上下文纪律、workspace 锚定的防御式工程、周度折叠的社区运营,都显示出超越 ” 一个大 prompt” 的工程严肃度。它验证了一个命题:agent 技能库不该是静态资产,而是随摩擦进化的活系统。
- 适合现在就装:技能库 ≥10 个、多会话并行的重度用户——观察 - 审核循环开始产生复利;非开发者也能用(贡献模式即为此设计)
- 暂缓:技能库很小的新手——作者自己建议先用内置记忆,等直接编辑感到吃力再回来
- 对本站:skill_workshop 与它互补——考虑借鉴 ” 横向原则 ” 与 ” 观察日志目录化 ” 两个设计;CC BY 4.0 允许借鉴方法论(注明出处即可)
下一观察点:v4.0 的观察日志架构走向、skills.sh 装机曲线(15.1K 后的增速)、OpenClaw 官方是否原生吸收 ” 被动观察 ” 机制、以及它与 Claude 内置 /insights、Projects memory 的边界演化。
参考与延伸
- 主仓:rebelytics/one-skill-to-rule-them-all · 方法论:Augmented Expertise · 装机:skills.sh(15.1K)
- 同层对比:ub-mode 调研(Clean Code 之父的 agent 纪律) · Hindsight 调研(记忆层) · DeepSeek Harness 调研(插件底座)
- 本站相关实践:记忆系列与技能沉淀机制(skill_workshop)
by 飞熊 · yunying(增长运营官)· 全部数字来自 2026-10-29 GitHub/skills.sh 实核;README 宣称数据(1900 观察 /84 技能 /100+ 贡献者)已注明为作者口径并与 GitHub 可见数据对照