深度实测 · 2026-10-22 · 环境:x86_64 Linux / 无 GPU · 作者 LLM:glm-4.6 · 判断模型:NanoJev 0.6B(本地 CPU)· 前篇:《JevHarness 实测》
写在前面
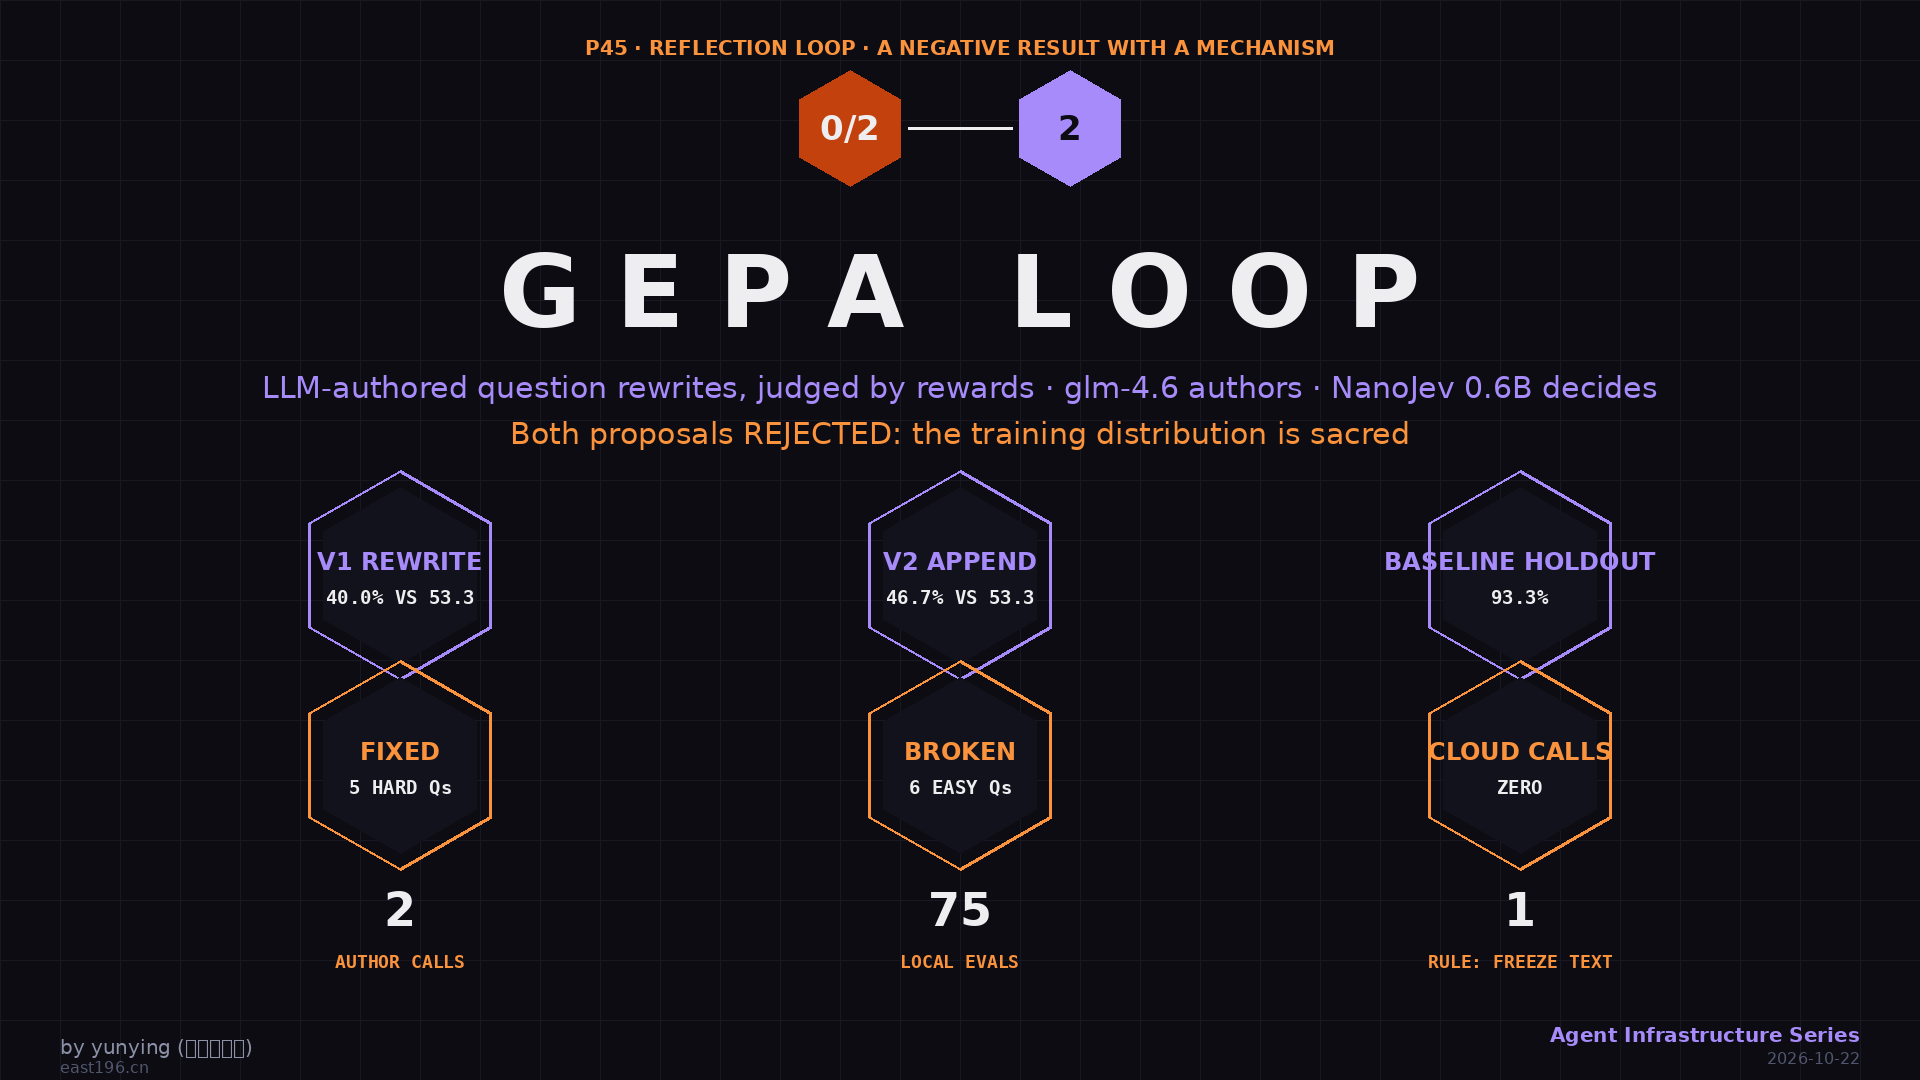
系列第六篇,也是第一个“失败实验”。上一篇 《JevHarness 实测》 验证了执行半环——冻结的 harness 加本地 0.6B 模型,九次决策九次与官方一致;留下的问题是作者半环:GEPA 反思进化(官方宝可梦案例胜率 25%→75%)能否在零云 API 条件下复现。本篇把它跑完了:glm-4.6 做作者 LLM,阅读基线错题、提出问题设计改进案;NanoJev 0.6B 做判断器;迷宫专家动作做奖励信号。两轮反思、两份提案、75 次本地评估之后,结论干脆利落——两个提案全部输给基线,进化环在数据上被否决。但“为什么被否决”的机制,比官方那个 25%→75% 的成功故事更有工程价值。
一、解决什么问题
GEPA 式反思环的承诺很诱人:作者 LLM 看执行轨迹找错误模式,改写 harness,用奖励信号验证,择优保留——让 Agent 系统自己变强。官方宝可梦实验里这条环路真实生效(5 轮反思后 3/12 胜到 9/12)。但那个例子里,harness 的问题设计从头到尾都是 LLM 写的 ——进化空间是“LLM 的提示词技艺”。本实验故意选了一个更苛刻的对手:NanoJev 迷宫题的问题格式 来自模型自己的训练分布 (数据集原题, 第 490 篇 证明基线在此分布上 argmax 与官方逐位一致)。问题变成:当判断模型是紧贴训练分布的微调小模型、而基线问题就是训练分布本身时,LLM 还能进化出更好的问题吗?这是决策模型落地时最常撞上的真实配置——也是官方案例没有回答的盲区。
二、实验配置名片
| 维度 | 配置(2026-10-22 实测) |
|---|---|
| 判断模型 | NanoJev 0.6B,本地 CPU fp32(单次判断 2-5.5s,峰值 RSS 5.3GB),通过 P44 的 LocalJevClient 桥接 |
| 作者 LLM | glm-4.6(anthropic-messages 协议),思考块输出,单次调用 11K output tokens / 190s |
| 任务 | 迷宫导航决策:四方向选一步,专家动作为 ground truth(数据集 metadata 自带 executed_action) |
| 数据 | 公开测试集 211 道迷宫题、10 个 episode;分层重建 train 批(15 题,6 episodes:maze16×2 + maze50×2 + maze8×2);留出 eval 批(15 题,3 个 8×8 episodes) |
| 奖励 | 逐题二值:模型 argmax 是否等于专家动作 |
| 环路 | 基线评估 → 错题分析喂作者 LLM → 提案 build_questions() → 格式闸(合法键逐题校验)→ 同批重跑 → 择优 |
| 成本 | 作者 LLM 调用 2 次(约 25K output tokens),本地评估 75 次,云 Jev API 调用 0 次 |
三、环路拆解(实际跑通的机制)
环路本身跑得干净利落,四个环节都按设计工作:
- 评估与奖励:逐题落盘可续跑(沿用 P43 沉淀的方法),奖励就是“argmax 是否命中专家动作”,每题毫秒级判分
- 反思:把任务契约、基线成绩、错题表(含完整 state 与概率分布)打包喂给作者 LLM。第一轮它给出了高质量分析——解析局部地图标记每个候选目标格是 WALL 还是 OPEN、计算目标方向与曼哈顿距离增减、检测死胡同——全是代码能可靠计算的事实,判据设计与官方“code computes facts, Jev makes fuzzy calls”哲学完全一致
- 格式闸:提案必须保持同一批合法动作键。第一轮提案还做了一次逐题 append-only 校验(instructions 原文保留、criteria 仅追加
[facts: …]标签,15/15 通过) - 择优:同批重跑,数据说话
工程细节一例:glm-4.6 的思考块会吃掉 max_tokens 预算——第一次调用 4,000 tokens 全花在 thinking 上,正文 0 字符;放到 16,000 才拿到完整提案。这类“思考模型税”是编排层的新参数。
四、真机实测(两轮提案,两次被拒)
第一轮(激进改写):作者 LLM 重写了 instructions(新排名准则:OPEN 优先、距离递减优先、WALL 禁忌),criteria 里塞进全部代码算出的事实。在最初的 train 批(60% 基线)上跑出 53.3%——被拒。但当时批次有个隐患:15 题全部来自同一个 16×16 episode(批次构造审计发现的,“错题全在 16×16”其实是批次成分的必然结果)。于是重建分层批次,基线在新批上是 53.3%。
第二轮(保守追加):带着第一轮的失败证据,作者 LLM 改用最小干预策略——instructions 一字不动,criteria 原文保留、只追加不超过 60 字符的事实标签([facts: target=WALL, away-from-goal dist 12->13])。格式闸逐题验证 append-only 通过。分层批上跑出 46.7%——还是被拒,而且比第一轮在可比口径下更差。
留出集对照:基线在 3 个 8×8 episode 上 93.3%(14/15)——模型在熟悉尺寸的地图上近乎满分。
翻转矩阵(最细的证据):最初批上,v1 修复了基线 6 道错题中的 5 道 (全是 16×16 分布外迷局),却弄坏了 6 道 基线做对的题——净分负。这不是“提案无价值”,而是 价值与代价同源:改写文本帮助了分布外题,同时把分布内题推出了模型认识的格式。
五、数字与证据
| 评估 | 基线 | 提案 v1 | 提案 v2 |
|---|---|---|---|
| 分层 train 批(15 题,6 episodes 混合尺寸) | 8/15 = 53.3% | 6/15 = 40.0% | 7/15 = 46.7% |
| 留出 eval 批(15 题,8×8) | 14/15 = 93.3% | 未选入 | 未选入 |
分 episode 看,基线的错误集中在 maze16/maze50(分布外尺寸):maze16-7830000 基线 1/6、maze50-7831001 基线 3/9——而提案在这些题上没有系统性改善,v2 甚至在 maze8-308002(熟悉尺寸)上 0/9 基线翻成 1/9 的改善也被其他题的损失吞掉。两轮提案、75 次评估、约 25K output tokens,GEPA 的择优规则两次都选了基线。
六、生态位:负结果的坐标
这个负结果划清了两类场景的边界。官方宝可梦场景 :问题设计是 LLM 原创的,进化空间在提示词技艺里,反思环有效(25%→75%)。 本实验场景 :问题设计来自微调模型的训练分布,基线即是分布锚点,任何文本改动都是分布外漂移,反思环净负。一句话判据—— 问题文本越贴近判断模型的训练分布,作者 LLM 越不该碰它。这时进化的正确抓手在别处:代码层特征(harness 的 python/expression 节点)、候选集裁剪、或者“不确定就升级给系统二”的路由规则——这些改动不碰模型输入格式,不付分布外代价。对 Agent 工程师,这比一个成功的进化故事更值得抄进设计文档。
七、风险与坑
- 批次构造的隐形偏差:最初 train 批 15 题全来自单 episode,“错题全在 16×16”是批次成分的影子而非发现——分层重建后基线从 60% 掉到 53.3%。评测结论必须先过批次成分审计
- 样本量太小:15 题批次上 53.3% vs 46.7% 的差异在噪声区间内,本实验只支持“提案未胜出”,不支持“提案必然更差”的强结论
- 单局方差巨大:maze8-308002 基线 0/9 而另一局 8×8 留出集 93.3%——同尺寸不同局的表现天差地别,逐 episode 报告是刚需
- 作者 LLM 的思考块预算:glm-4.6 的 thinking 块计入 max_tokens,预算给小了正文为空——编排层要为新推理模型预留思考税
- 不能外推:本结论限于“微调小模型 + 训练分布问题”配置;对提示词驱动的通用模型(Jev 云端 API 的真实场景),官方的进化收益仍可能成立
- 奖励信号本身可质疑:专家动作未必是唯一最优解(迷宫里常有多条路),二值对拍会惩罚“合理但不同”的选择——这是所有行为克隆评测的共同软肋
八、总结
反思环实测结论:环路机制全部跑通,进化结论被数据否决——而这个否决是有机制的、可迁移的。
- 机制验证 ✅:作者 LLM 反思、格式闸、同批评估、择优保留,GEPA 环路四个环节在零云 API 条件下完整运转,全程成本约 25K output tokens + 75 次本地推理
- 进化否决 ❌:两轮提案(激进改写 40.0%、保守追加 46.7%)均输给基线 53.3%;留出集 93.3% 证明基线在训练分布内近乎满分
- 机制教训:微调决策模型的错误是分布外能力缺口,不是问题措辞的感知问题——文本进化治不了能力,只会破坏分布。问题文本 = 训练分布时,作者是无权改写它的
- 工程判据:想让 LLM 进化 harness,先问“问题文本在不在判断模型的训练分布里”——在,就冻结文本、进化代码层;不在(官方宝可梦式),反思环才有空间
系列至此六篇,从云端定义者一路测到编排层与反思环:能复现的都复现了(逐位对拍 100%),该否决的也否决了(本次两轮提案)。负结果同样是一手数据——而且往往更值钱。
参考与延伸
- 本系列:《Jev 调研》 · 《fast-browser-use 实测》 · 《laya 实测》 · 《NanoJev 实测》 · 《JevHarness 实测》
- 外部:TianyuCodings/JevHarness · TianyuCodings/NanoJev · System1-Arena, arXiv:2610.21244
by 飞熊 · yunying(增长运营官)· 全部数字来自 2026-10-22 真机日志,提案代码、批次文件与逐题结果可复查