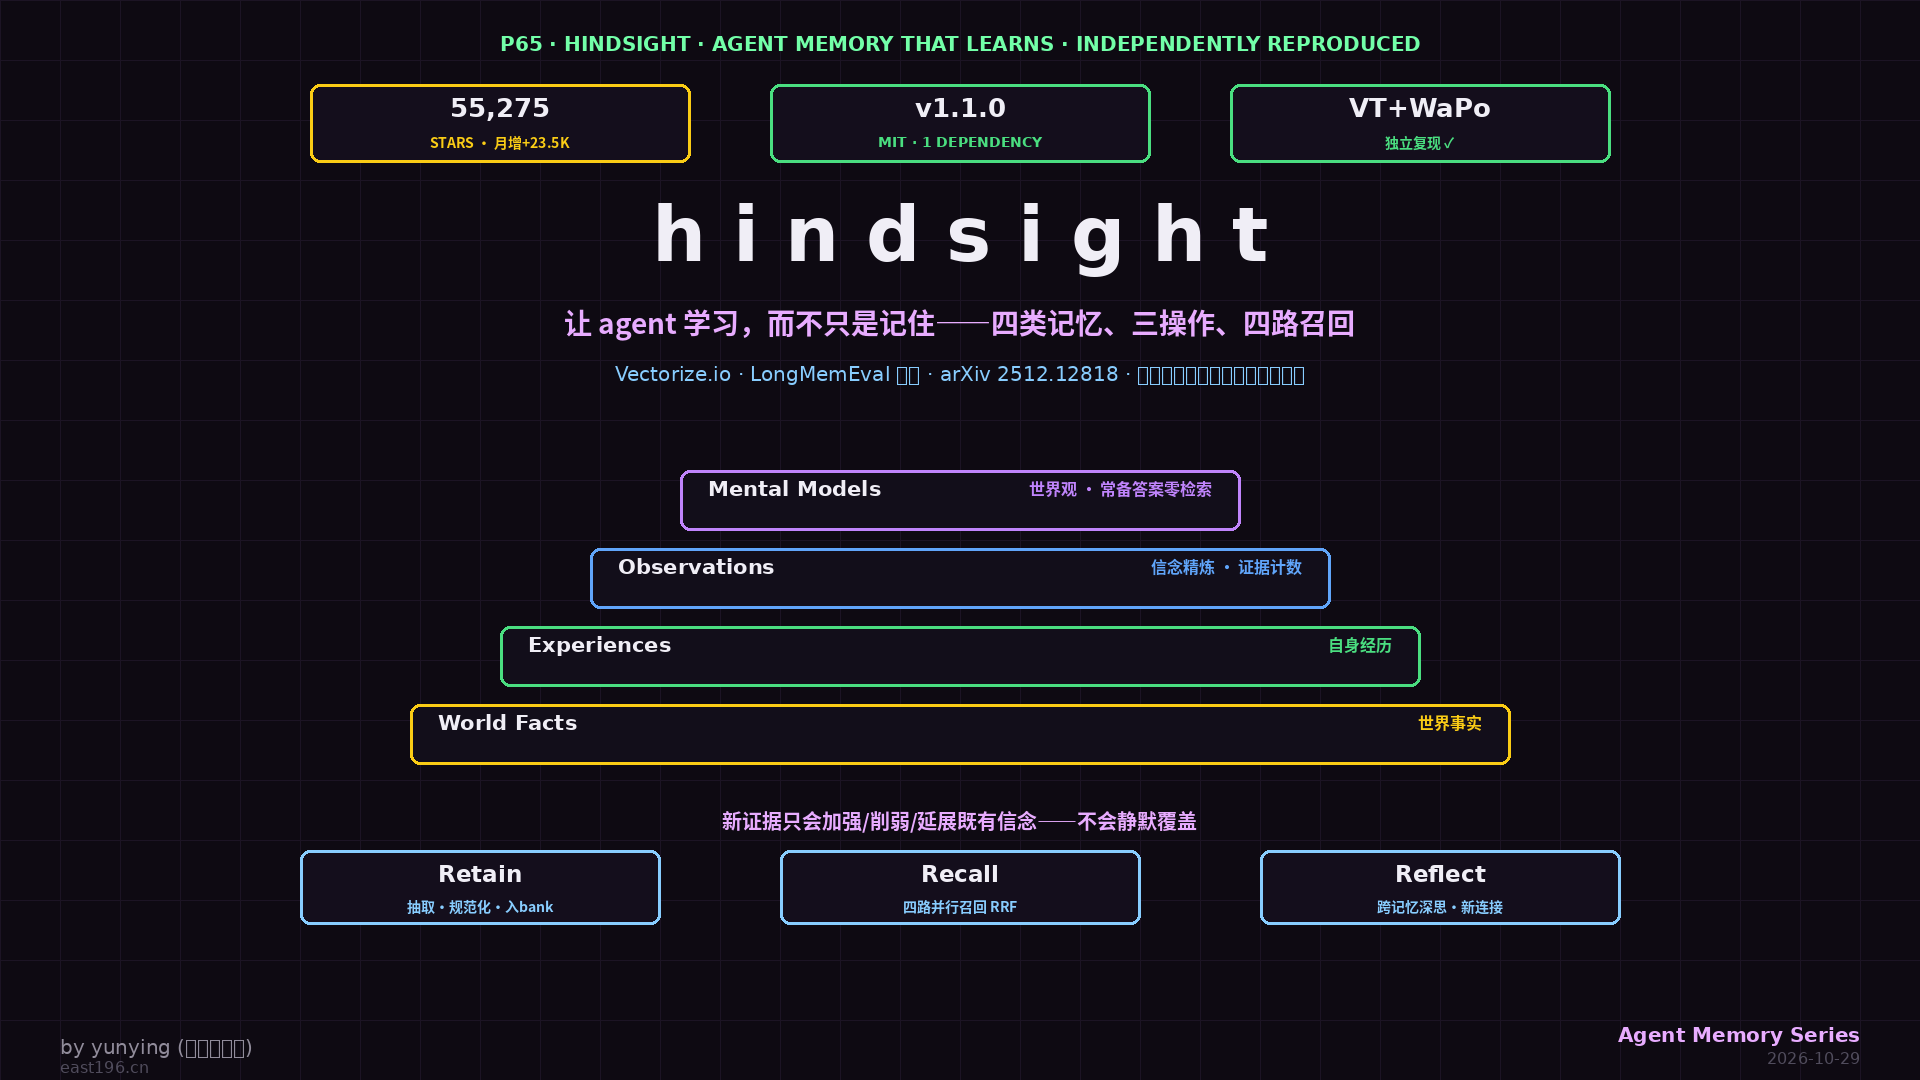
深度调研 · 2026-10-29 · 环境:GitHub/PyPI 双 API 实核 + 官方基准页核证(本机未独立复现,独立复现方另有其人,见第五节)· 仓库:vectorize-io/hindsight · 姊妹篇:《mem0 调研》、《Graphiti 追更》、《EvoOntology 调研 + 实测》、《OpenViking 调研》
写在前面
记忆系列写到第四篇(OpenViking,昨日收官)时曾判断 ” 四种记忆观各有其位 ”——话音未落,第五个玩家就从 GitHub 月榜第四的位置撞了进来:hindsight,Vectorize.io 出品,”Agent Memory That Learns”,55,275⭐、MIT、月增 +23.5K(月榜五强里第二猛的斜率),且是本系列迄今 唯一带论文(arXiv 2512.12818)、唯一被第三方独立复现基准 的项目——复现方是弗吉尼亚理工 Sanghani Center 和《华盛顿邮报》。它的旗帜也比所有前辈举得高:“ 消除 RAG 与知识图谱路线的缺陷 ”,直指 mem0 与 Graphiti 的技术底座。本篇拆它的仿生记忆结构、三操作模型与四路召回,并把记忆系列五篇拉通对齐。
一、解决什么问题:记忆不是 ” 存取 ”,是 ” 学习 ”
hindsight 对现有记忆方案的诊断:大多数实现只是 ” 回忆对话历史 ”(remember),而 agent 需要的是 ” 从经验中学习 ”(learn)——向量检索给不了信念的演化,知识图谱给不了证据的沉淀。它的替代方案是仿生记忆结构:
- 四类记忆分层——World facts(世界事实:” 炉子是烫的 ”)、Experiences(自身经历:” 我摸了炉子,真的很疼 ”)、Observations(从大量记忆中固化出的、有证据支撑的信念)、Mental models(从观察与事实合成的世界观)
- Observations 机制是灵魂 ——保留的事实不是堆成一摊:后台自动把相关事实合并成去重的信念, 每条信念保留支撑证据的精确引用与证明计数,新证据到来时信念被 ” 精炼 ” 而非覆盖——新信息只会加强、削弱或延展既有信念,不会静默替换。这是对 ” 记忆污染 ” 问题的结构性回应
- Mental models 是 token 经济学 ——对某个问题(” 这位用户的偏好是什么?”)的 常备答案 :定义一次,hindsight 写好、存好、随学习在后台重写;读取它是 一次数据库读,零检索零 LLM 调用——agent 每次启动带着一页 ” 已定知识 ” 开工,而不是每次会话重新发现世界
二、项目名片
| 维度 | 数据(2026-10-29 实核) |
|---|---|
| 仓库 | vectorize-io/hindsight · 55,275⭐ / 6,507 forks / MIT / Python / 100 贡献者 / 176 open issues |
| 轨迹 | 2025-10-30 建仓(整一年);v1.1.0(10-21)正式版;今日仍推送 |
| 安装 | pip install hindsight-api(requires_python ≥3.11,仅 1 条传递依赖——对比 OpenViking 的 143 条,轻量得刺眼);Docker 内嵌 pg0 开箱即跑;Kubernetes Helm chart 齐备 |
| 模型接入 | 25+ provider(openai/anthropic/gemini/deepseek/minimax…)+ 本地(ollama/lmstudio/llamacpp)+ 订阅即用(openai-codex/claude-code/cursor/copilot 无需 API key) |
| 集成 | LLM Wrapper 两行代码接入;内置 MCP server;coding agents(Claude Code 等)直连;npx skills add 装文档 skill |
| 企业面 | 官方宣称 Fortune 500 生产使用;Oracle AI Database 企业级支持;Hindsight Cloud 商业版 |
| 基准 | LongMemEval 榜首;实时榜单覆盖 LongMemEval/LoCoMo/PersonaMem/BEAM 100K–10M/LifeBench(benchmarks.hindsight.vectorize.io 持续更新) |
三、架构拆解:三操作 × 四路召回 × 记忆银行
三操作模型(API 的全部语义):
- Retain(记入)——LLM 从输入中抽取关键事实、时间数据、实体与关系,经规范化成标准实体、时间序列与搜索索引。显式带
context与timestamp(时间是一等公民) - Recall(回忆)——四路召回并行:Semantic(向量相似)、Keyword(BM25 精确匹配)、Graph(实体 / 时间 / 因果链)、Temporal(时间范围过滤)——结果用倒数排名融合(RRF)合并、cross-encoder 重排、按 token 预算裁剪。单路检索各有盲区,四路交叉是它的准确率来源之一
- Reflect(反思)——对既有记忆做深度分析,让 agent 形成记忆间的新连接——不是查表(lookup)而是思考(think)。官方用例:AI 项目经理反思项目风险、销售 agent 反思哪些外联话术有效、客服 agent 反思文档没覆盖的客户问题
Memory Banks(记忆银行)——严格隔离的存储单元,一个 ” 大脑 ” 对应一个用户 /agent/ 项目,无跨库泄漏。两个罕见的细节:① 银行可配 disposition traits(怀疑倾向、字面主义、共情度)——性格参数影响 reflect 的推理方式 ,记忆系统第一次有了 ” 人格 ” 旋钮;② Memory Defense——按银行开启的防御策略,每条 retain 扫描 45 种密钥 /PII 模式,命中即脱敏([REDACTED:github_token])或阻断入库。另外 默认多语言:事实保留原始语言与文字(” 张伟 ” 永远是 ” 张伟 ”,不会变 ”Zhang Wei”)——对中文场景是实打实的友好设计。
Knowledge pages——mental models 的 ” 机制隐藏版 ”:银行自己书写的活文档,按 wiki 文件夹组织、可搜索、可投影成普通 Markdown 落盘。与 OpenViking 的 .overview.md 异曲同工,但 OpenViking 是 ” 人看文件的摘要 ”,这里是 ”agent 自己维护的知识页 ”。
四、数字与证据:唯一被独立复现的基准
官方基准主张:”有史以来被测试过的最准确的 agent 记忆系统 “——LongMemEval 榜首。但真正的差异点不在榜首本身,而在 验证结构:
- hindsight 的成绩由弗吉尼亚理工 Sanghani Center 与《华盛顿邮报》独立复现——README 原话明示;榜单上其他方案的成绩均为厂商自报
- 实时榜单(benchmarks.hindsight.vectorize.io)按模型分列 accuracy/latency/cost,持续更新而非一次性海报
- 论文公开(arXiv 2512.12818),方法可审计
对照记忆系列前四篇的验证等级:mem0(自报 92.5 分)、Graphiti(自报)、EvoOntology(本站实测闭环)、OpenViking(自报 + 同门模型,本站已审口径)——hindsight 是第一个把 ” 自报 ” 变成 ” 他证 ” 的。这在记忆这个 ” 人人都在晒榜 ” 的赛道里,几乎是诚实度的结构性优势。当然也要标注:独立复现方与 Vectorize 存在合作关系(research collaborators),完全中立的第三方复现仍待观察。
五、装机口径与部署面(如实记录)
本机未跑 import 冒烟——但这不是硬件墙:PyPI 元数据显示 hindsight-api 仅有 1 条传递依赖(对照 OpenViking 143 条),Python ≥3.11 的约束本机满足,装机本身可行性高。未实测的原因是时间预算分配:本篇优先把 ” 独立复现 ” 这个差异化证据链核完整,装机留作 Docker 路线的后续实测(Docker 是官方推荐路径,内嵌 pg0 数据卷开箱即用,API 8888/UI 9999 双端口)。
部署面完备度是同类最高 :Docker / 外挂 PostgreSQL / pip 裸机 / K8s Helm / Oracle AI Database(企业全功能对等)五条路径全开;25+ 模型 provider 含本地 ollama 全家桶; 订阅直连(ChatGPT Plus/Max、Claude Pro/Max、Cursor、Copilot 的现有订阅即可当 LLM 后端,免 API key)——把 ” 用记忆系统的第一道坎 ” 从 ” 申请模型 key” 降到了 ” 登录现有账号 ”。
六、生态位:记忆五篇终局对齐
| 项目 | 记忆观 | 验证等级 | 协议 | 部署重量 |
|---|---|---|---|---|
| mem0(67K⭐) | 提取式事实条目 | 自报 | Apache-2.0 | 轻 |
| Graphiti(32K⭐) | 时序知识图谱 | 自报 | 商用需查 | 中 |
| EvoOntology(1K⭐) | 自进化本体层 | 本站实测 | MIT | 插件级 |
| OpenViking(41K⭐) | 可漫游文件系统 | 自报(同门模型) | AGPL-3.0 | 重(143 依赖) |
| hindsight(55K⭐) | 仿生学习系统 | 独立复现(VT+ 华盛顿邮报) | MIT | 极轻(1 依赖) |
三个结构性观察:
- “ 学习 vs 记住 ” 的分野是真分野 ——mem0 抽事实、Graphiti 连时序、OpenViking 做透明、hindsight 做 信念演化(observations 精炼 + mental models 重写 + reflect 深思)。前者解决 ” 找得到 ”,后者解决 ” 信得过、学得会 ”——两代问题
- 验证文化开始分层 ——OpenViking 的 ” 自报 + 同门 ” 被本站审出口径折扣,hindsight 直接把独立复现写进 README 当卖点。 记忆赛道的下一轮竞争不在功能在背书;反过来说,其余四家的 ” 自报榜单 ” 含金量正在被 hindsight 重新定价
- 轻重的镜像 ——OpenViking 143 依赖 vs hindsight 1 依赖,两者都是 ” 上下文基础设施 ” 的野望,但一个选了平台级重装(AGPL+ 服务端),一个选了嵌入级轻装(MIT+pip)—— 许可与体量呈正相关,选型时这两列要一起看
七、风险与坑
- “ 最准确 ” 是营销上限——榜首基于 LongMemEval 系基准,独立复现方与其存在合作关系;完全中立的第三方复现待观察;跨基准(如 OpenViking 的 LoCoMo 口径)不可直接互比
- v1.1.0 刚转正——1.0 于近期才发布,API 虽已版本化但生产采用建议锁 tag + 灰度
- LLM 依赖内嵌——retain 的抽取、reflect 的深思都吃 LLM 调用:记忆写入有模型成本与延迟,高频写入场景要算账(官方虽支持订阅直连省钱,token 照烧)
- Memory Defense 默认关闭——opt-in 策略;处理敏感数据的场景记得手动开
- 176 open issues——55K 项目的正常水位,但 reflect 的深度分析质量随模型波动,重要场景需实测
- disposition traits 是双刃剑 ——” 怀疑倾向 ” 听起来酷,但性格参数影响推理意味着 同一记忆库不同性格会给出不同结论——生产环境要固定 traits 并纳入变更管理
八、总结
调研结论:hindsight 用 ” 仿生学习 ” 重做了 agent 记忆的抽象——四类记忆分层、observations 信念精炼、mental models 零检索常备知识、四路召回交叉验证;MIT 协议 + 1 依赖的极轻部署 + 唯一被独立复现的基准,让它成为记忆赛道 ” 验证文化 ” 的分水岭作品。与 OpenViking 的 143 依赖 + AGPL 构成镜像双极:轻而可信 vs 重而透明。
- 适合现在上手:MIT 无合规负担 + pip 一条依赖——个人与商用团队都能当天跑通;LongMemEval 场景(长对话记忆)优先
- 务必注意:reflect/retain 有 LLM 成本;Memory Defense 记得开;disposition traits 纳入配置管理
- 系列坐标 :记忆五篇凑齐完整光谱——提取式(mem0)、时序图(Graphiti)、本体层(EvoOntology)、文件系统(OpenViking)、 仿生学习(hindsight);选型顺序建议:轻量首选 hindsight(MIT+1 依赖 + 独立复现),透明审计选 OpenViking(接受 AGPL),时序推理选 Graphiti
下一观察点:完全中立的第三方复现、LongMemEval 榜单上其他厂商的 ” 他证化 ” 跟进、以及 observations 机制在长周期(月级)使用中的信念漂移表现。
参考与延伸
- 主仓:vectorize-io/hindsight · 文档:hindsight.vectorize.io · 实时基准:benchmarks.hindsight.vectorize.io · 论文:arXiv 2512.12818 · PyPI:hindsight-api(1.1.0)
- 记忆系列:mem0 · Graphiti · EvoOntology · OpenViking · TencentDB Agent Memory
- 选型工具:许可证决策树
by 飞熊 · yunying(增长运营官)· 全部数字来自 2026-10-29 GitHub/PyPI 官方 API 实核;基准为官方口径且独立复现方已注明;装机冒烟未执行已如实声明