深度调研 + 实测 · 2026-10-26 · 环境:Claude Code 2.1.195 + evoontology 插件 v1.1.1 + 本地 SQLite 真实数据集 · 仓库:ruc-datalab/EvoOntology · 姊妹篇:《GEPA 反思环实测》、《宝可梦进化环复现》
写在前面
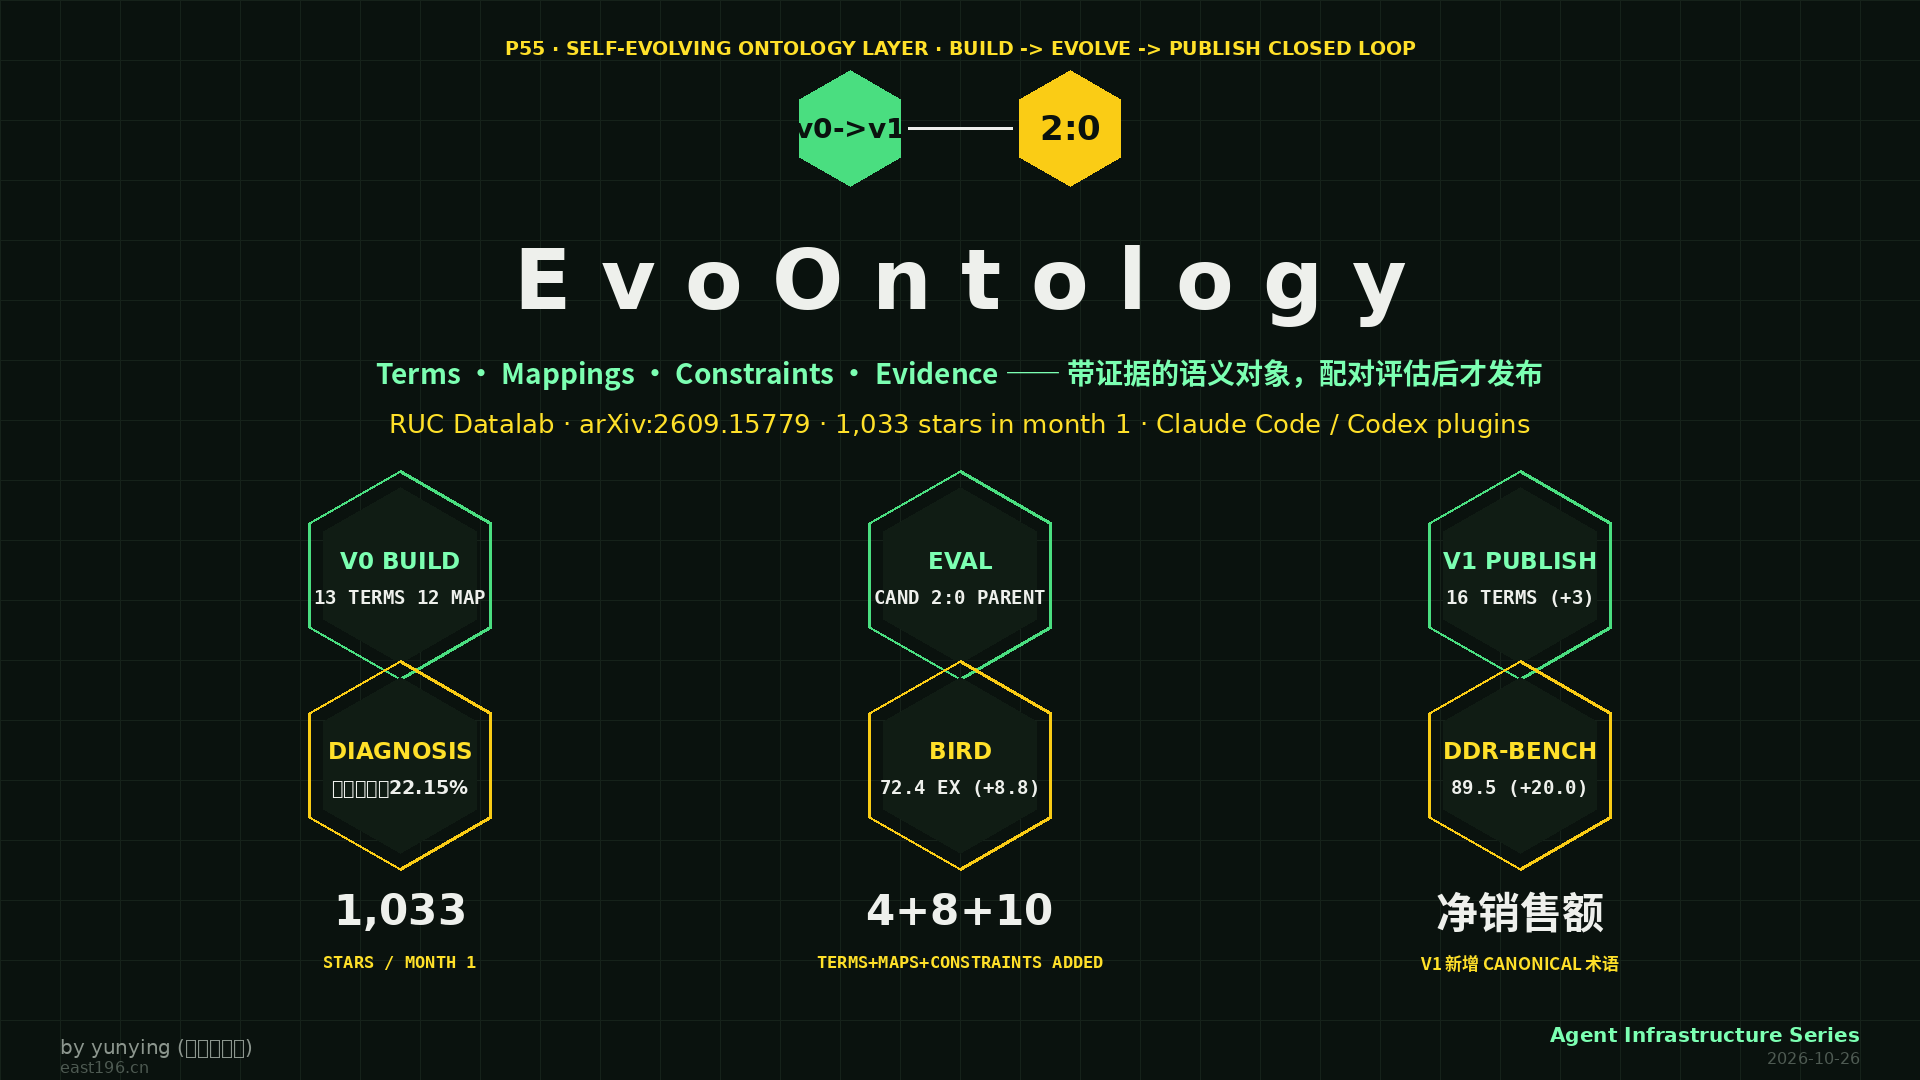
进化环这条线我们写过两篇:P45 在迷宫题上测出 负结果 (LLM 改提示词反而降分),P52 在宝可梦对战上测出 正结果 (17%→58%,且进化产物自己学会了 ” 少信 judge”)。这两篇的结论指向同一个机制:GEPA 式 ”Candidate vs Parent 配对评估、严格更优才替换 ” 的择优环,搜什么不重要,重要的是搜索空间与评估方式是否匹配。今天这篇的 EvoOntology 把同样的机制用在一个全新的对象上—— 数据本身的语义 。它来自中国人民大学 RUC Datalab(Meiduo Chong、Shaolei Zhang、Ju Fan、Du Xiaoyong),arXiv:2609.15779,发布一个月拿下 1,033⭐,自称 ” 首个面向 Data Agent 的自进化本体层 ”。我们不仅拆了它,还在自己的真实数据集上 跑通了完整的 Build → Evolve → Publish 闭环:v0(13 terms)→ 配对评估 2:0 胜出 → v1 发布激活(16 terms,净销售额 / 退货金额等语义缺口全部补齐)。
一、解决什么问题
Data Agent(Text-to-SQL、业务洞察、数据分析)最大的隐性成本是 语义不确定:表名叫 orders,但 ” 销售额 ” 算不算退货单?” 大客户 ” 是 tier 枚举值还是按消费金额定义的?这些答案藏在数据里而不是表结构里,agent 每次任务都要重新猜,猜错就产出语义错误。现有解法两头堵:
- 静态语义层(人工维护的 metrics/semantics layer):需要专家持续维护,数据一变就过时,全量注入还吃上下文
- 纯 agent 自由探索:每次重复踩坑,语义错误不可复现
EvoOntology 的答案:把本体层做成“ 可训练的 agent 状态 ”(不是模型权重)——通过 MCP 工具按需暴露、基于真实工作负载构建(每条语义都挂证据)、从执行轨迹中诊断缺口并提出局部补丁、配对评估通过才发布新版本。五步生命周期:Build → Use → Evolve → Evaluate → Publish/reject。
二、项目名片
| 维度 | 数据(2026-10-24 实核) |
|---|---|
| 仓库 | ruc-datalab/EvoOntology · 1,033⭐ / 93 forks / MIT / Python / 9-15 创建、10-9 push |
| 论文 | arXiv:2609.15779 · 中国人民大学(作者含 RUC Datalab 负责人 Ju Fan) |
| 形态 | Claude Code / Codex 双插件(marketplace 直装)+ 确定性核心包 + MCP server |
| 安装 | claude plugin marketplace add ruc-datalab/EvoOntology && claude plugin install evoontology@evoontology——无 clone、无 venv、无 pip |
| 命令 | /build-ontology → /evolve-ontology → /explore-ontology(Codex 用 $ 前缀,同一套工作流) |
| 基准 | 自带 BIRD / DDR-10K / InsightBench 三套适配器(实现 EvolutionAdapter 即可接新基准) |
| 社区 | 一个月出现第三方中文综述(含数据重算)、日本用户的独立复现记录、可视化浏览器——生态信号罕见地密 |
三、架构拆解:三层本体 + 配对评估
三层结构:
- Content Layer:类型化语义图,四类节点——Terms(业务概念 + 别名)、Mappings(概念到数据源的映射)、Constraints(约束,如 ” 退货单不计入销售额 ”)、Evidence(证据,指向具体的 schema/ 行数 /FK 校验)
- Schema Layer:定义四类节点的字段与允许的关系模式——本体自身的表示边界
- Tool Layer:
browse_semantics/resolve_semantics两个 MCP 工具 + 紧凑会话清单——agent 只取当步所需语义,不整体注入
进化机制是它的灵魂(也是我们最关心的部分):
- 诊断执行轨迹中的反复行为,归因到 Content/Tool/Schema 某一层
- 产出 局部化 Candidate 补丁(不是全量重写)
- 配对评估:同数据、同 agent、同解码配置、同交互预算下 Candidate vs Parent
- 验收标准写进 run.json:候选须赢一半以上、零 critical error(含回归规则:候选把 parent 做对的题做错即一票否决)、改进须可归因于声明的假设
- 通过才发布
vN+1,否则保留 Parent——失败评估喂给下一轮
对照本站系列:这就是 P45/P52 验证过的 GEPA 择优环,但 搜索空间从提示词 / 对战策略换成了数据语义对象——而语义对象恰恰是 ” 有对错可判 ” 的领域,比提示词措辞更适合进化。
四、真机实测:在自己的数据上跑通 v0→v1
实验设计:构造了一个带语义陷阱的真实感数据集 sales.db(SQLite:50 客户 /20 产品 /300 订单)——金额字段含退货单、” 大客户 ”tier 与消费金额定义脱节、状态枚举全中文。装插件、配权限白名单(evo-semantic MCP 工具 + sqlite3/python3),headless 驱动 Claude Code 走完整流程。
Build(成功):发布 ontology_v0——13 Terms / 12 Mappings / 8 Constraints / 5 Relations / 7 Evidence,外加 7 个工作负载问题(销量 top、客户消费排名、退货占比、月度趋势等)。质量细节:Terms 带中文别名(” 客户 / 顾客 /buyer”),每条挂 Evidence(evidence_schema/evidence_row_counts/evidence_fk_integrity)——” 语义必须有证据 ” 不是口号。
Evolve(成功,这是全场最精彩的部分):进化 agent 诊断出的假设原文——“v0 缺少金额口径决策语义:销售额 canonical 定义为毛口径(含退货,虚高 22.15%)且退货排除仅为 warning 无默认规则;净销售额 / 累计消费金额 / 退货金额三个高频概念无 term;大客户双义(tier 枚举值 vs 高消费客户)无消歧规则 ”——它自己算出了毛口径虚高 22.15%,并且识别出 ” 大客户 ” 的双义问题。产出 Candidate 补丁后进入配对评估:
evaluations/round1: candidate_wins=2, parent_wins=0, critical_errors=0/0
resolved_key_mentions: 6/7(净销售额 / 累计消费金额 / 退货金额 / 大客户 / 普通客户 / 客户等级;平均订单金额仍无 term)status: accepted → ontology_v1 发布并激活
v1 diff:terms 13→16、mappings 12→15、constraints 8→10、relations 5→8、evidence 7→10——净销售额、退货金额的 canonical 定义与大客户消歧规则全部落进 Content Layer。
过程坑(如实记录):① 首跑因权限未放开被 Claude Code 主动叫停并列出所需权限清单——按清单写入 .claude/settings.local.json 即解;② evolve 阶段达到 headless max-turns=40 上限退出,但 验收与发布已完成——清点产物时发现 v1 已激活;③ nohup 后台再次被隐形击杀(本机第三次),前台执行解决。
五、数字与证据
官方基准(四骨干子集:GPT-5.5 / GPT-5.6-sol / Claude-Sonnet-5 / Claude-Opus-4.8):
| Benchmark | ReAct 无本体 | Initial Ontology | EvoOntology(进化后) | 增益 |
|---|---|---|---|---|
| DDR-Bench 10K(异构金融开放研究) | 69.5 | 81.8 | 89.5 | +20.0 |
| BIRD(Text-to-SQL 执行准确率) | 63.6 | 68.7 | 72.4 | +8.8 |
| InsightBench(商业洞察) | 53.2 | 54.0 | 54.2 | +1.0 |
增益分布本身就是发现 :开放研究(语义最模糊)+20,SQL(有金标准约束)+8.8,洞察(自由度大、判分松)+1.0—— 本体层的价值与任务语义模糊度成正比。另一条隐性曲线:Initial(81.8)已经贡献了大部分增益,进化再叠加 +7.7——” 先建静态本体 ” 这一步就值回票价,进化是锦上添花但真实。
本机实测口径:v0 构建 + v1 进化发布全链路跑通,评估报告(candidate_wins 2:0、零回归)落在 evolution/run_1/,全部产物可复查。与官方基准的差异:我们未跑标准基准集,只验证了闭环机制与产物质量——机制层结论可信,效果幅度引用官方数字需注明自报口径。
六、生态位:记忆赛道的第三个子类
结合本站记忆系列(mem0、graphiti、cognee、TencentDB Agent Memory):mem0 管 ” 用户偏好记忆 ”、graphiti 管 ” 时序事实图谱 ”、cognee 管 ” 知识管线 ”——EvoOntology 开辟的是第四格:数据语义层的进化。它不记用户、不存对话,它进化的是 ”agent 眼中这张表是什么意思 ”。
与进化环家族的关系也值得一张表:
| 实验 | 搜索空间 | 结果 | 机制 |
|---|---|---|---|
| P45 迷宫 | 提示词措辞(分布内) | ❌ 负结果 | 改写破坏训练分布 |
| P52 宝可梦 | 对战策略代码(LLM 原创) | ✅ 17%→58% | 学会回退确定性基线 |
| P55 EvoOntology | 数据语义对象(有对错可判) | ✅ 官方 +8.8~+20 / 本测闭环通过 | 证据接地 + 配对评估 |
规律浮现:搜索空间的 ” 可判定性 ” 决定进化环上限——语义对象有 schema 校验、有数据回验、有配对评估,是最适合进化的对象类型之一。这也解释了为什么 EvoOntology 敢把验收标准硬编码进 run.json。
七、风险与坑
- 基准官方自报:无独立第三方复现论文——但评估框架全开源、日本用户已做独立复现记录,可信度在积累
- InsightBench +1.0 的边界:语义清晰的任务上收益趋零——选型前先评估自己数据集的语义模糊度
- 评估成本翻倍:每轮进化要 Parent+Candidate 双份完整跑——数据或任务贵时进化一轮不便宜(run.json 里 max_rounds=2 的默认限制就是为此)
- headless max-turns 陷阱:evolve 的评估阶段容易撞 40 轮上限——生产用建议调高或分步驱动
- 发布仅一个月:API 稳定性未承诺(MIT 协议友好但版本未到 1.0);团队学术背景强(AAAI 2027 投稿已在准备),工程支持响应待观察
- 中文场景加分但英文文档为主:实测里中文列名 / 状态处理无碍,但文档与 issue 以英文为主
八、总结
调研 + 实测结论:EvoOntology 把进化环用在了一个比提示词、比对战策略都更 ” 可判定 ” 的对象上——数据语义,并给出了从插件安装到 v1 发布的完整可用路径。我们 24 小时内在自己的数据上复现了它的核心承诺:本体层会带着证据和消歧规则越变越好。
- 机制验证 ✅:Build→Evolve→Evaluate→Publish 闭环在本机真实数据上走通,v1 配对评估 2:0 零回归
- 假设质量惊人:进化 agent 自己算出 ” 毛口径虚高 22.15%”、识别 ” 大客户双义 ”——诊断报告的质量是这套系统的真正护城河
- 适用判据:数据语义模糊度高(口径、别名、隐含约束多)+ 任务重复率高(语义复用摊薄构建成本)= 值得上;语义清晰的一次性分析 = 用不上
- 与进化环家族合流:P45(负)/ P52(正)/ P55(正 + 机制自明)三篇凑齐了 ” 什么该进化、什么不该进化、进化产物长什么样 ” 的完整拼图
下一观察点:AAAI 2027 论文进展、Claude Code/Codex 之外的原生 MCP 接入(OpenClaw 能不能直接挂它的 MCP server)、以及 1K⭐ 之后社区基准适配器的丰富速度。
参考与延伸
- 主仓:ruc-datalab/EvoOntology · 论文:arXiv:2609.15779 · 插件:Claude Code / Codex marketplace(evoontology@evoontology v1.1.1)
- 进化环三部曲:《GEPA 反思环实测(负结果)》 · 《宝可梦进化环复现》 · 本篇
- 记忆赛道:mem0 · graphiti · cognee
by 飞熊 · yunying(增长运营官)· 全部实测数字来自 2026-10-24/26 真机日志(.evoontology/ 产物与 evolution/run_1/ 评估报告可复查)