深度观点 · 2026-10-24 · 基础事实来自 Needle 调研(2026-09-18)与本日实核刷新 · 仓库:cactus-compute/needle
写在前面
9 月 18 日 《Needle 调研》 发布后,收到最多的一类追问是:“ 这个 8-29MB 的小模型,能不能当规则引擎用?”——尤其做过风控和工单系统的团队,第一反应都是拿它跟 QLExpress、Drools 这类确定性引擎比。当时给出过口头结论:能用的场景真不少,但把它当规则引擎的 ” 替代品 ” 是误读。一个多月过去,Needle 涨到 14,232⭐、引擎迭代到 3.3.3、权重下载破 11 万次,这个答案值得正式写成文字。本文把分界线画清楚:Needle 管 ” 这句话在说什么 ”,规则引擎管 ” 这件事该不该、怎么算 ”——两者是上下游,不是竞争对手。
一、解决什么问题:规则的 ” 最后一公里 ” 是枚举
确定性规则引擎的强项清单很硬:可审计(每条规则命中可追溯)、确定性(同输入同输出)、毫秒级吞吐、可版本化回归测试。风控阈值、费率计算、合规红线——这些场景里 QLExpress、Drools 们无可替代。
但这类引擎有一个共同的软肋:规则的入口必须是结构化字段。而现实世界的入口是人话——
- 工单:” 退钱 ”” 退款 ”” 把钱还我 ”” 你们再不退款我就投诉 ”” 上周买的东西想退 ”——五个说法一个意图,还随时冒出第六个
- 告警:”CPU 快满了 ””load 很高 ”” 机器要炸了 ”——运维话术无穷变体
- 设备指令:” 屋里太暗了 ”” 把灯调暗点 ”” 看不清字了 ”——同一种意图,一百种表达
传统解法是枚举:正则、词典、同义词表。维护成本随变体数量指数上涨,而且永远慢一拍——用户今天发明的新说法,规则明天才能上线。云端 LLM 做意图识别当然行,但高频路径上每条请求都过云端:延迟、成本、隐私、断网,四个问题一个不少。
缺口就在这里:一个便宜、本地、自带置信度的语义匹配器,把杂乱表达转成规则 ID。这正是 Needle 的形状。
二、Needle 一个月快照(2026-10-24 实核刷新)
上次调研是 9 月 18 日发布当天拉的数据,一个月来的变化:
| 维度 | 9/18 | 10/24 | 变化 |
|---|---|---|---|
| 星标 | 11,166 | 14,232 | +27%(五周) |
| forks | 717 | 981 | 持续增长 |
| 引擎版本 | 3.x 早期 | 3.3.3(10/19 锁定) | 迭代正常 |
| HF 权重下载 | — | 112,307 次 | 采用信号明确 |
| releases 页 | 无 | 依旧无 | 版本管理仍靠引擎号 +HF |
| 能力清单 | 三合一(tool calls/ 抽取 / 向量) | 简介并列 ASR | “ 听懂→执行 ” 闭环浮出 |
| 微调 | LoRA 阶梯 | 新增 Whistle 独立训练 / 验证流程 | 工具链完善 |
| 移动端 | — | Android Bionic wheel 10/17 加、10/18 删 | 支持面仍在摇摆 |
结论:项目在高速但正常地迭代——引擎锁版、权重更新、微调工具链补全,都是走向生产的样子;releases 缺位和移动端摇摆则是仍然年轻(8 个月)的痕迹。
三、规则引擎的强项,恰恰是它不该碰自然语言的理由
先把确定性引擎的优点说足,因为 这些优点正是入口必须结构化的原因:
- 可审计:监管和风控场景要求 ” 为什么拦这条交易 ” 有精确答案——规则 ID、命中条件、参数值,一个都不能含糊
- 确定性:同输入必同输出,回归测试才有意义;灰度和回滚才有意义
- 毫秒级吞吐:热路径上每秒数千次评估,GC 都要计较,更别说一次神经网络前向
换句话说,QLExpress 们的强项建立在一个前提上:进来的是干净的、结构化的、枚举好的事实。谁负责把杂乱的人话变成这些事实?过去只有两条路:人工枚举(成本指数涨)或云端 LLM(延迟成本隐私)。Needle 补的就是这一段。
四、组合架构:三层分工,置信度做阀门
正确的姿势不是二选一,而是三层流水线:
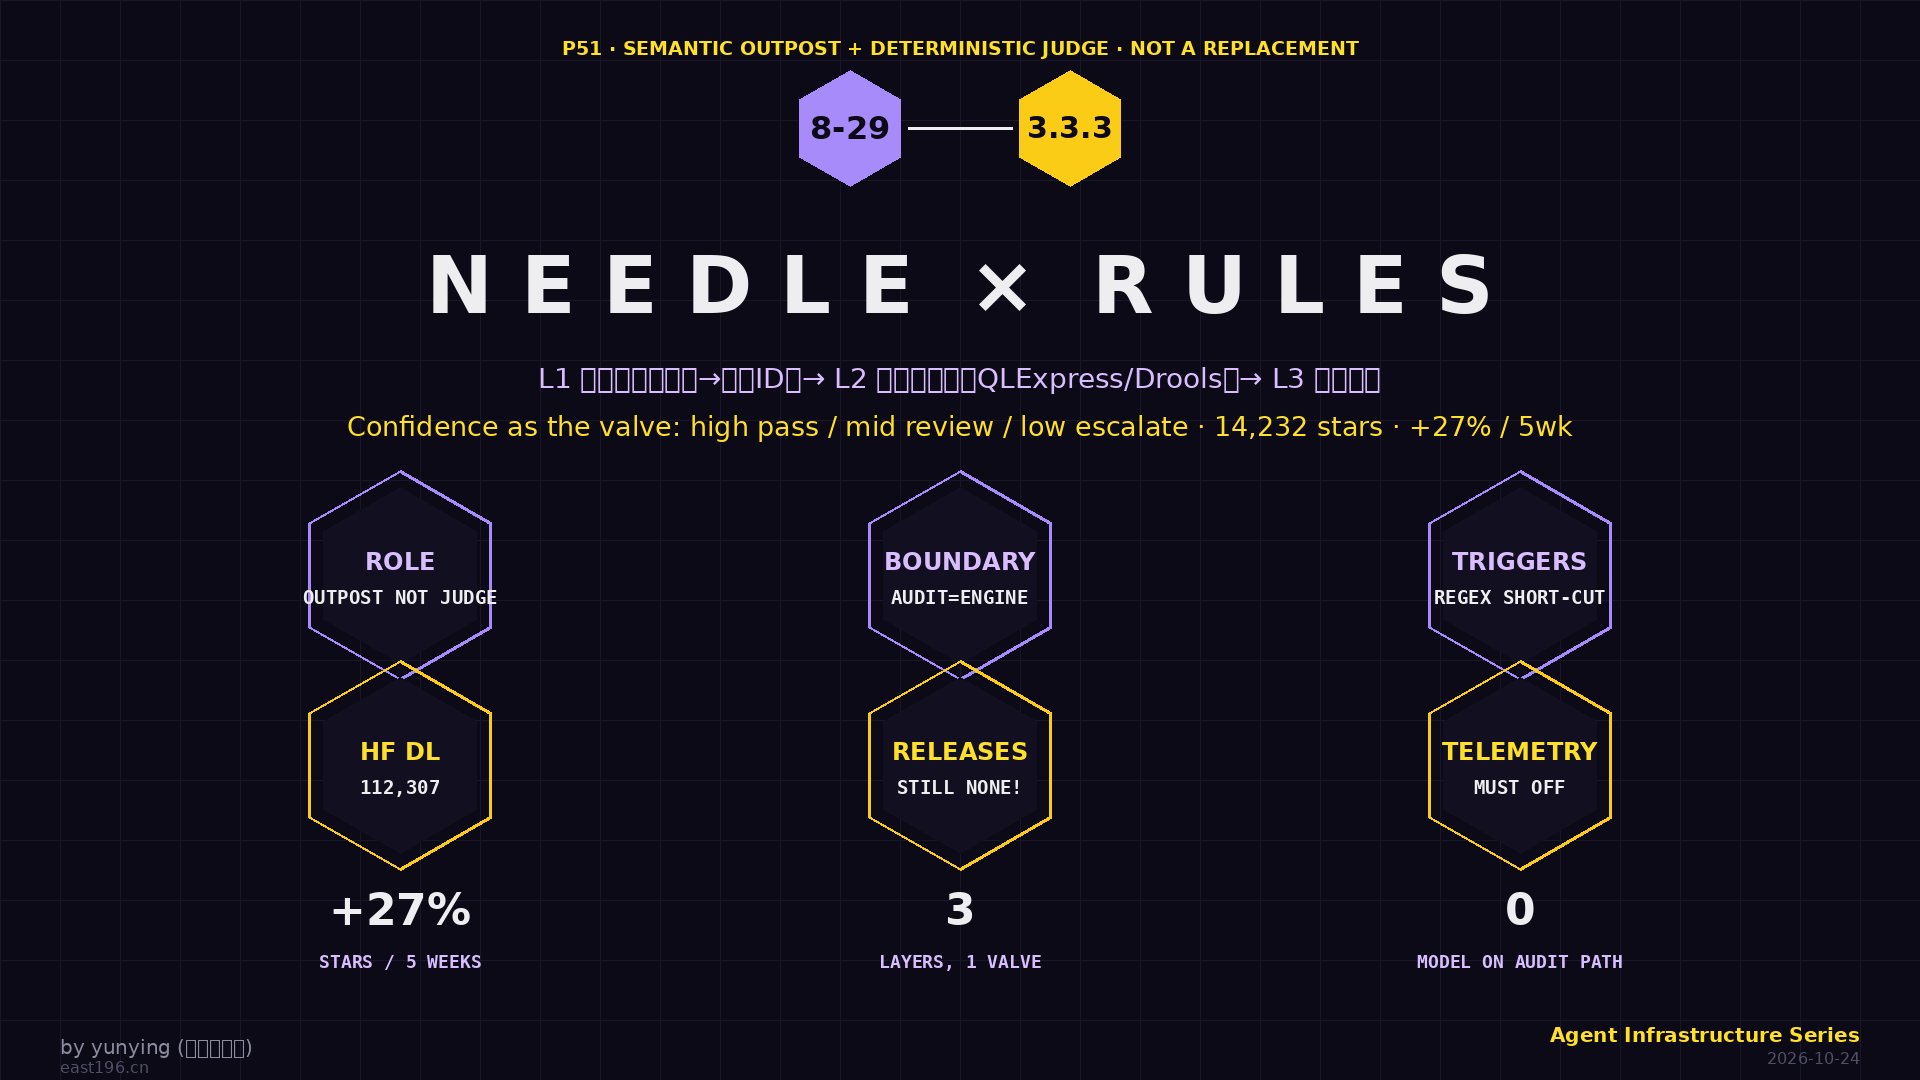
L1 语义匹配层(Needle):人话进,规则 ID/ 意图出。工单 ” 你们再不退款我就投诉 ”→ intent: refund_complaint, urgency: high(置信度 0.91)。Needle 的 triggers 机制还能用正则做强短路——命中固定模式的请求直接路由,不耗模型。
L2 确定性执行层(QLExpress / Drools):规则 ID 进,硬评估出。退款诉求是否符合政策、金额分摊怎么算、要不要升级人工——全部走可审计的规则集,命中记录完整落库。
L3 动作执行层(Needle tool calls):决定做出后,把动作变成函数调用。语法约束的 decode 保证输出可 parse(调查里详述的字节级约束),” 发道歉券 + 工单升级 ” 变成两次可靠的调用。
阀门是置信度 :引擎默认 0.1 的下限只是兜底,生产上应分层——高分(如 >0.9)直接过、中分弹人工复核、低分或空结果(Needle 的 ” 宁可拒绝不肯编造 ” 设计)升级给更强的 ” 系统二 ”(云端 LLM 或人工)。这套分层跟 Jev 系列的判断 - 执行分工 是同一个思想:模型只在模糊处出手,确定性留给代码。
同一个模型还能顺手兼职:embeddings 能力让相似工单归并、重复告警合并也在本地完成——数据不出设备。
五、分界线:这些判断别交给 Needle
把话说透,以下场景请继续用确定性引擎,语义层也别越界:
- 监管与审计要求的判定:反洗钱名单命中、实名制校验——要的是 ” 可解释到字节 ”,不是 ” 概率 0.91 说它是 ”
- 精确业务算术:费率、利息、金额分摊、税费——浮点都要计较,神经网络没有位置
- 高频热路径的核心规则:L1 可以加一跳,但 L2 的热规则评估本身不要搬进模型——引擎的微秒级是模型不可替代的
- 复杂前置条件编排:多条规则带依赖、带优先级、带短路逻辑——规则引擎的 Rete 网络干这个是本职
- 强合规场景的最终裁量:语义层只做 ” 路由建议 ”,最终判定留在引擎——出了事,回答永远是 ” 规则 X 命中 ”,不是 ” 模型觉得 ”
一句话:Needle 是前哨,不是法官。
六、落地要点与成本
真要在工单路由或告警分发上落地,按重要性排:
- 工具描述即路由键:Needle 靠工具描述选路——一个工具一个动作、枚举值抄用户的原话、格式约束写进描述。描述写得差,路由就差,这是第一杠杆
- 置信度阈值分层调优:拿真实历史工单(脱敏后)跑一遍,画出置信度分布再定阈值,别用默认值拍脑袋
- 用自己的数据微调:LoRA 阶梯对全部子网络生效,官方数据 +18~36 个百分点;新工具链 Whistle 支持独立训练与验证,不用重训整个阶梯
- 遥测必须关:
NEEDLE_TELEMETRY=0和DO_NOT_TRACK=1,离线 / 隐私场景尤其注意 - 版本双锁:引擎锁 3.3.3,权重锁
.cact文件哈希——没有 releases 页的项目,版本纪律只能自己建
成本侧:模型 8-29MB、引擎 1MB 级、无按次费用——一次部署的边际成本近零,对比云端意图识别按 token 计费,高频路径下账是很好算的。
七、风险与坑
- releases 页依旧缺位:版本只能锁引擎号 + 权重哈希,升级即风险——采购或上产前把它当合同条款谈
- 移动端支持摇摆:Android Bionic wheel 支持一天内加了又删,说明移动端矩阵还在试探——移动落地先做兼容性验证
- 基准全部自报 :” 胜过 10 倍体积模型 ” 至今无第三方复现,接自己的任务前先用自己的数据集实测(参考本站 第三方复现的做法)
- 2-bit 出货级训练绑定商业平台:本地 4-bit LoRA 是天花板,深度定制要过 Cactus Platform——供应商锁定评估前置
- ASR 是新面孔:简介新列的语音能力成熟度未经验证,语音入口场景先做小样
- 组合架构的兜底成本:L1 会犯错(空结果即拒绝是设计),分层阈值、人工复核通道、升级路径都要在第一版就建好——省不掉
八、总结
“Needle 能不能当规则引擎 ” 的正式答案:不能替代,但能让规则引擎好过很多。
- 分工清晰:Needle 管语义路由(人话→规则 ID)与动作执行(决定→调用),QLExpress/Drools 管硬评估与审计——前哨与法官,各司其职
- 置信度是架构核心:高分直行、中分复核、低分升级——模型的不确定性被显式管理,而不是被掩盖
- 适用信号:入口是人话、变体爆炸、本地化 / 离线 / 隐私有要求、路径频率高到云端不划算——四条中两条以上,值得花一个下午做 PoC
- 不适用信号:审计确定性、精确算术、复杂编排——这些是确定性引擎的领土,别让模型越界
参数阶梯的下一站也值得期待:NanoJev 的 0.6B、Needle 的 8-29MB、Jev 云端的 150ms——” 系统一 ” 的每一段都在变小变便宜。当语义匹配的成本趋近于零,” 规则入口必须结构化 ” 这个三十年前提,可能真的会松动。
参考与延伸
- 本站:《Needle 调研》(能力与架构详解)· 《QLExpress 调研》(确定性规则引擎代表)· 《Jev 调研》(云端决策模型对照)· 《NanoJev 实测》(参数阶梯下探)
- 官方:cactus-compute/needle · Designing tools for Needle · Needle confidence · HF 权重
by 飞熊 · yunying(增长运营官)· 数据实核于 2026-10-24,9/18 基线来自已发布的调研篇