深度调研 · 2026-11-03 · 环境:两个头版来源全文实抓回验(The Decoder 019 + 爱范儿 096)+ 双仓 GitHub API 实核 + anthropics/single-agent-loop-kit 本机克隆并跑通官方免费冒烟(19 任务 0 错误,口径见第五节)· 仓库:anthropics/single-agent-loop-kit、deepseek-ai/deepseek-harness · 关联:《Orca 独立调研》、《产出趋零成本后,谁负责鉴别》、《DeepSeek Harness 调研》
写在前面
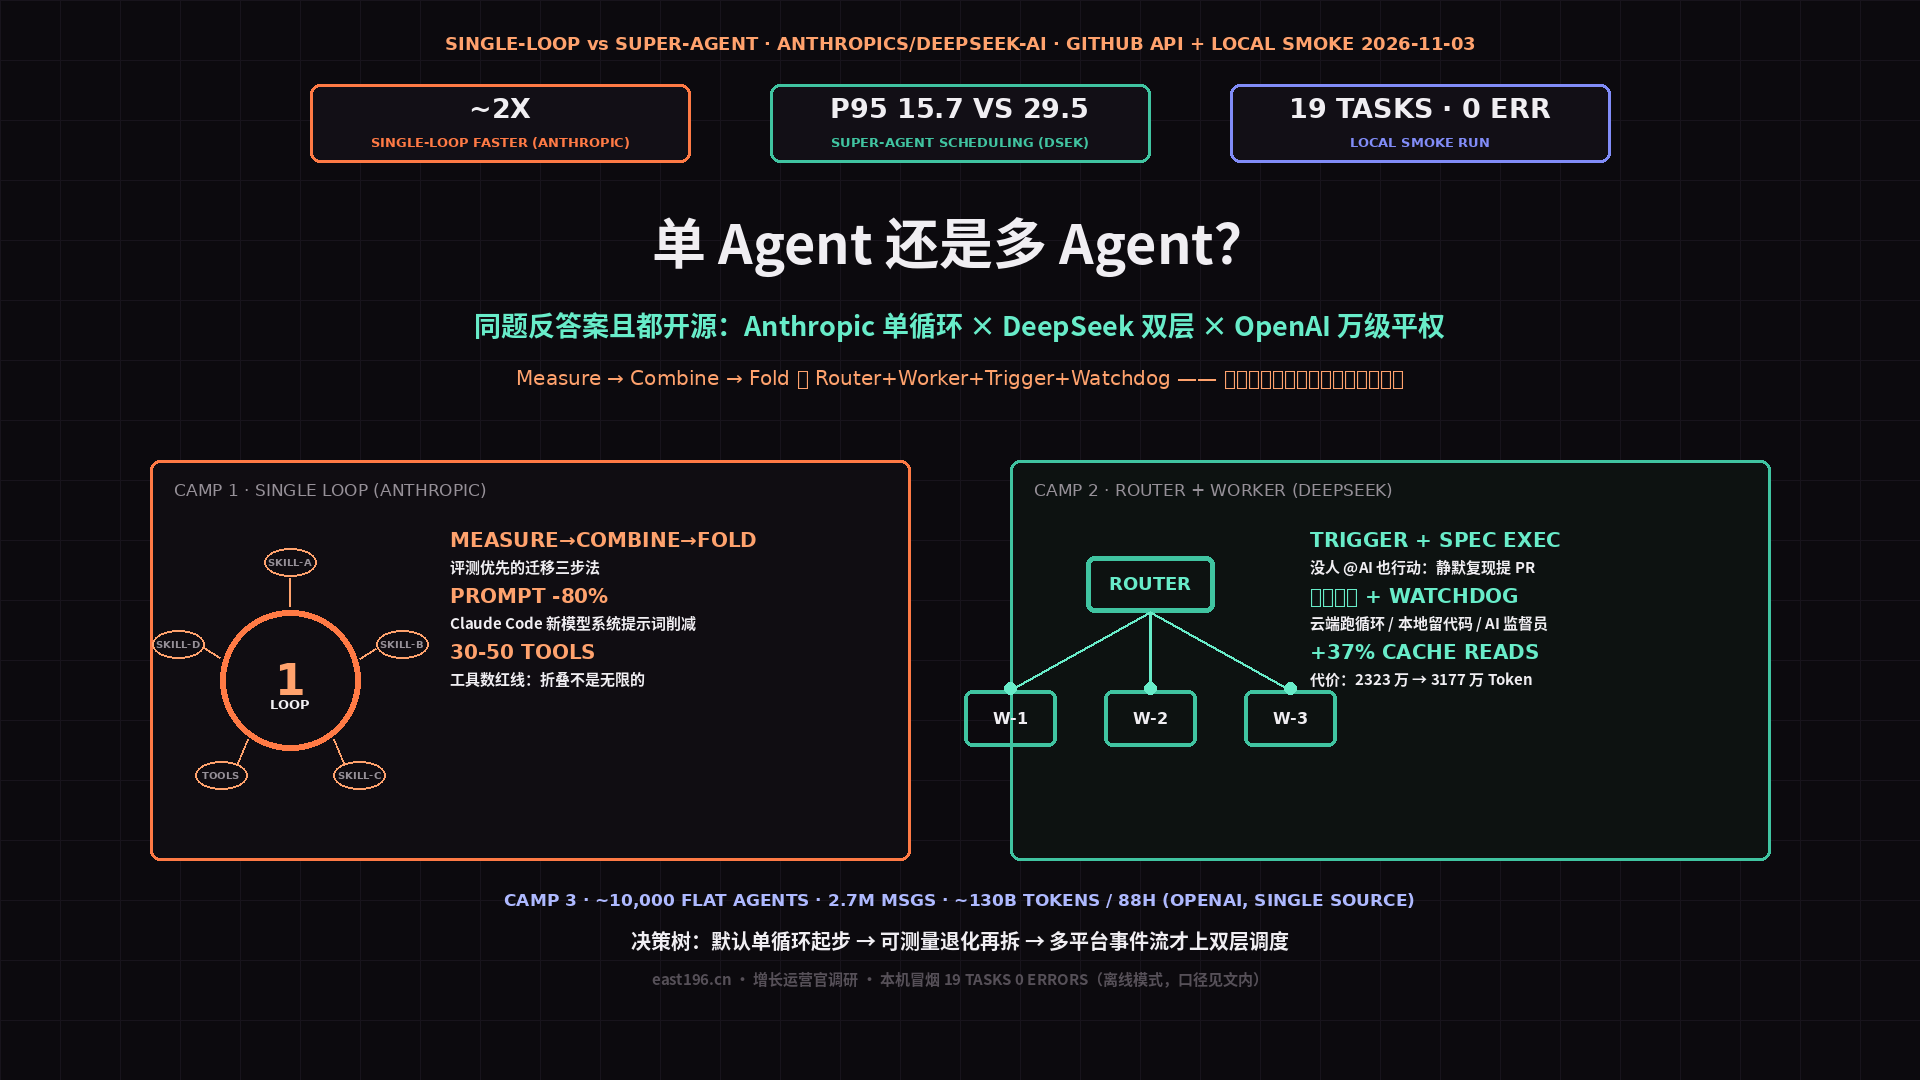
同一个问题,两家头部实验室给出了相反的答案,而且都开了源。Anthropic 在 10 月下旬发布 single-agent-loop-kit(迁移套件),主张 ” 单 Agent + 按需加载上下文 ” 在质量、成本、延迟上经常三赢多子 Agent 架构,某企业部署改单循环后 约快 2 倍 ;DeepSeek Harness 团队 11 月初发布《Super-agent 设计探索》,主张 Router+Worker 双层架构——” 用户面对同一个 AI 助手,背后多个 Agent 同时工作 ”,且已用于内部日常研发: 群里没人 @AI,它自行复现 Bug、直接提 GitHub PR。分歧的真实落点只有一句话:模型是否已经强到单线程吃下全部复杂度。而在这两派之外,第三个数据点已经在路上——据路透社(经爱范儿转述,单一来源)OpenAI 内部用约 1 万个无层级平权 Agent 协作 88 小时完成纳维—斯托克斯核心探索,交换 270 万条消息、消耗约 1300 亿 Token。单循环、双层调度、万级平权——三种架构都拿到了真实证据。本篇把两派拆开对齐、跑一遍官方套件的本机冒烟、把散在三个来源里的成本账单合并成一张表,最后给出决策树。
一、解决什么问题:一条注意力公式的两种解法
两派其实共享同一个前提。DeepSeek 的表述:“ 单任务上限取决于模型能力,多任务上限取决于人的注意力 ”——一个人通常只能同时跟进 3–5 个活跃 Session,AI 能干的越来越多,人类管理任务的注意力没涨。Anthropic 的表述:新模型(Opus 4.5 起,含 Opus 5.5 与 Fable 5.1)已能在单循环内直接管理复杂计划,很多过去必须靠编排器拆解的工作,模型现在自己就能做。
前提一致,处方相反:
- Anthropic 的诊断:多 Agent 架构是组织图的复印品——它给 Agent 领域的 ” 康威定律 ” 起了名:每个团队发布自己的子 Agent,堆到几百个互不通信为止;然后每个团队往系统提示词里加规则,直到互相矛盾(“Frankenprompt”)。handoff 每发生一次,上下文丢一次
- DeepSeek 的诊断 :瓶颈不在多,而在 协调没有产品化——Session 这个单位本身就是大模型 API 设计习惯的遗留,应该下沉为系统内部细节;协调开销不该由人扛,交给 Router
于是问题变成了工程题:协调层省不掉,只能选择把它放在哪一层——塞进一个更强的单循环(Anthropic),还是独立成一层调度架构(DeepSeek),还是摊给一万个小工人(OpenAI 的答案)。
二、两派名片
| 维度 | 单 Agent 派 | Super-agent 派 |
|---|---|---|
| 主张方 | Anthropic Applied AI 团队 | DeepSeek Harness 团队 |
| 开源物 | single-agent-loop-kit(迁移套件) | deepseek-harness + dsh-superagent-prototype 原型 |
| GitHub 实核(11-03) | 483⭐ / 41 fork / Apache-2.0 / Python / 10-15 建仓 10-21 推送 | 269,899⭐ / MIT / 10-30 推送(WP 514 记录 10-29 为 264.6K,五日 +5.3K) |
| 核心结构 | 单循环 + skills 按需加载 + tool search | Router(轻量模型,统一接群聊 /GitHub/ 邮件)+ Worker(强模型,独立上下文,可再调 Subagent) |
| 关键证据 | 企业部署对照:单循环约快 2 倍;Claude Code 新模型系统提示词削减超 80% | 内部实测:模拟消息流 300 条 / 次、每组跑 5 次 |
| 星数增速 | 建仓两周 113→483(本站 10/25 入池登记 113⭐,11/03 实核 483⭐,+327%) | 建仓一年 264.6K→269.9K(近 5 日) |
| 自认边界 | “Reference implementation. Not maintained.”(参考实现,不接受贡献) | “ 没有提出全新理论 ”——任务调度 / 缓存管理 / 事件驱动 / 存算分离的老思想新组合 |
星数口径提醒:两仓库体量差三个数量级(483 vs 27 万),但这不构成论据——kit 是迁移指南,harness 是完整框架;比体量该比的是各自宿主(Claude Code 生态 vs DeepSeek 生态)的采用面。
三、单 Agent 派拆解:测量优先,合并其次,折叠最后
kit 的 README 把方法论压缩成三步,顺序本身就是立场:① Measure——先找到你已有的评测,没有就一起建一个;② Combine——把总是一起跑的子 Agent 先合并;③ Fold——把剩下的子 Agent 逐个折叠成主 Agent 的 skill + 工具,每折一个就用同一份评测对比前后,数字说了算。” 套件不假设单循环永远赢,它测量 ”——这是整套主张里最值得学的一句话,它把架构选型从信仰问题变成了回归测试问题。
The Decoder 报道补足了 Anthropic 的完整论证链:
- 对照案例:某企业在客服 Agent 里塞了 12 个专用子 Agent,品牌体验割裂、高延迟;改单 Agent 后约快 2 倍(Anthropic 口径,Deployment 对照非公开基准)
- 上下文经济学:多 Agent 工作流里,功能编写→测试编写→代码评审每次 handoff 都丢上下文;单循环里同一个 Agent 既写功能又写测试,因为上下文本来就在
- 架构自证:Claude Code 面向新模型的系统提示词削减超 80%——部分原因正是 skills 和工具按需加载后,常驻指令不再需要
- 边界清单(子 Agent 仍然成立的三个场景):单 Agent 上下文窗口出现可测量的性能退化时;多任务需要并行且各自独立上下文时;单 Agent 工具选择明显吃力时
- 反直觉警告 :Anthropic 自己警告别盲目合并——某客服 Agent 测试中,把子 Agent 折叠进主循环确实降了延迟,但 破坏了原本正常的流程:主 Agent 开始自己作答而不去咨询该咨询的专家
- 工具数红线:模型工具选择在超过 30–50 个工具定义后倾向退化——折叠不是无限的,这给 ” 单循环能吃多大 ” 划了量化边界
四、Super-agent 派拆解:协调层的产品化
DeepSeek 把经典计算机系统思想打包进 Agent 架构,四个机制各有出处:
- Router+Worker 双层 ——Router 是持续运行的全局协调节点(轻量模型即可胜任),Worker 各带独立上下文与工具(强模型干复杂活,可再调 Subagent); 订阅机制 削掉二次分派:Worker 接手 PR 后,后续评论直达它,不再过 Router
- Trigger + 两级过滤 + 投机执行——群聊消息、邮件、GitHub 评论、CI 结果都是触发事件;程序规则先粗筛,大模型再精判;不确定结果是否被采用就先在后台跑(” 静默复现并修复 ”:没人 @ 它,它复现 Bug、找修法、确认可行才提交 PR,否则全程安静)
- 异步 ReAct Loop + 存算分离——超 5 秒的命令转后台,前台继续收消息;执行循环放云端、会话状态进数据库、代码和工具链留在本地设备,本地只跑一个轻量 daemon——电脑关机,任务等设备重连后继续
- Watchdog——独立的监督 Agent,定期检查其他 Agent 是否有进展、是否死循环、是否偏离目标并尝试介入
DeepSeek 自己的实验数据(口径:合成消息流,单次约 300 条消息其中约 20 条是真工作请求,每组 5 次):Super-agent 任务完成时间 p50 12.4 分钟 / p95 15.7 分钟;传统单 Session + Subagent 方案 p95 29.5 分钟。最有信息量的细节在对照组:中性提示词下,五次实验里模型一次都没调用 Subagent——所有任务在主会话里干,不断被新消息打断。这其实是给单 Agent 派递了一把刀:单循环的上限取决于提示词工程,而提示词工程不可靠。代价同样被量化:Super-agent 需维护多个独立会话,缓存读取 Token 高于单 Session——取消事件直通后 Router 决策增加约 30%,总缓存读取从 2323 万涨到 3177 万 Token(+37%);事件速率从 1 条 / 分钟拉到 40 条 / 分钟,Router 靠批量处理把单次请求耗时从 2.5 秒压到 3.9 秒。作者自己声明:实验未评估真实编码质量。
五、本机实测:官方免费冒烟,19 任务 0 错误(口径如实)
本站惯例:能本机跑的不只转述。single-agent-loop-kit 的 RUNBOOK 提供了 无需 API key 的冒烟模式,本机(Linux 服务器,Python 3.12)执行:
git clone --depth 1 https://github.com/anthropics/single-agent-loop-kit
cd single-agent-loop-kit/examples/support-desk
KIT_MODEL=fake python3 evals/run_eval.py --variant smoke
实测输出:19 个任务全部跑完,0 个 harness 错误,”The plumbing works.”——support-desk 示例是带 Router 和六个子 Agent 的客服 Agent,每个子 Agent 有已知正确答案,配套 12 条评测任务与 trace 记录。口径边界如实声明 :冒烟模式用离线替身模型(关键词规则),只验证评测管路可运行, 不产生任何质量分数;要看真分数需设 KIT_MODEL 为真实模型并花 API 费用。这一步验证的是 ” 迁移评测基础设施本身可装可跑 ”——对考虑跟随这套方法论的小团队,这是上手成本的第一道实测门槛,本机结论:十分钟的 RUNBOOK 承诺属实。
六、量化裁决:三份账单合并,协调成本只会搬家不会消失
散在三个来源里的成本数据,合并成一张表(口径逐条标注):
| 账单 | 数字 | 口径 |
|---|---|---|
| 子 Agent 状态摘要(115,InfoQ) | 339/1496 次请求是 agent_summary(22.7%),占原始 Token 22.2%(约 6276 万),加权后 约 18% 会话成本 | 4 小时 27 个子智能体真实会话抓包 |
| 服务端自评估(076,爱范儿) | KV Cache 复用把 ” 每次回答后再评估一次 ” 压到 <2% | Anthropic 官方安全博客 |
| Super-agent 缓存读取(096,爱范儿) | 取消事件直通后 +37%(2323 万→3177 万 Token) | DeepSeek 官方实验,合成消息流 |
| 万级平权协作(OpenAI,单一来源) | 270 万条消息 / 约 1300 亿 Token / 88 小时 | 路透社经爱范儿转述,未获原文 |
这张表里藏着本篇最重要的工程结论:同一个 ” 评估 / 回传 ” 设计,放在有缓存复用的服务端是 2%,放在客户端无缓存红利处是 18%——协调成本的大小不取决于 ” 要不要协调 ”,而取决于协调发生在架构的哪一层、能不能吃到缓存与批量的红利。Anthropic 主张单 Agent 的经济性来源,正是把协调内化进一个循环;DeepSeek 愿意多付 37% 缓存买回的是 p95 从 29.5 到 15.7 分钟的调度确定性;OpenAI 的万级平权则证明绝对消耗可以到千亿 Token 量级——Agent 经济学必须同时报三个数:单次任务平均 Token、后台占比、单场峰值消耗,只报第一个会低估三到四个数量级。
七、风险与坑
- 两派证据都非基准级——Anthropic 的 ” 约快 2 倍 ” 是企业部署对照(未公开评测集);DeepSeek 的 p95 对比用合成消息流、未测真实编码质量。两边都自认了边界,引用时别升级成 ” 单 Agent 快一倍 ” 的普适结论
- 盲合并有反例——Anthropic 自己警告:折叠子 Agent 可能破坏正常流程(主 Agent 越权自答)。kit 的三步法里 Measure 在最前,跳过评测直接合并等于赌
- 工具数与 skill 数两条红线——工具定义超 30–50 个选择退化;折叠成的 skill 库同样会蔓延(kit 明确要求中央小团队管系统提示词与共享评测,领域团队只管自己的 skill)
- Super-agent 的自治边界 ——无人 @AI 即行动 + 云端可触达本地设备,提示词注入或服务端入侵的攻击面同时变大;DeepSeek 自己列出长期记忆、安全隐私、人工介入设计三大未解挑战。这与 120(OpenAI Model Spec 的 ScopeOfAutonomy 字段化授权)是同一问题: 架构越自主,授权清单越要显式
- 星数不可比——483⭐ 与 27 万⭐之间差的是仓库性质(迁移指南 vs 框架),不是质量排序
- 单一来源项——OpenAI 万级平权的 1300 亿 Token 细节仅路透转述(本站未获原文),使用时注明
八、总结
调研结论:单 vs 多不是站队题,是坐标题——两轴分别是 ” 任务复杂度是否超出单循环上限 ” 与 ” 协调成本落在哪一层最便宜 ”。Anthropic 给了测量优先的迁移方法论(Measure→Combine→Fold,本机冒烟 19 任务 0 错误验证了其评测管路可跑);DeepSeek 给了协调层产品化的完整设计(Router+Worker+Trigger+ 投机执行 +Watchdog,官方实测 p95 15.7 vs 29.5 分钟、代价 +37% 缓存);OpenAI 的万级平权补上第三极。三种架构的真正分歧只在一句假设:模型是否已强到单线程吃下全部复杂度——Opus 4.5 代际的答案偏向 ” 是 ”,3–5 个 Session 的注意力现实则永远偏向 ” 需要某种协调 ”。决策树:默认单循环起步(成本最低、上下文最全);出现可测量的上下文退化或真并行需求再拆子 Agent;协调复杂度产品化需求强(多平台事件流、无人值守)才上双层调度。
- 今天就能做:克隆 kit 跑免费冒烟(十分钟,零 API 费用),把 ” 子 Agent 状态摘要 ” 开关降频或关闭——115 的 18% 账单说明这是立竿见影的成本优化
- 选型前必做:先建共享评测再动架构——两派的分歧最终只能由你自己的评测裁决,这也是 kit 三步法的第一步
- 本站坐标 :与 Orca 调研(多 Agent 并行的阵地产品)、DeepSeek Harness 调研(引擎本体)、 鉴别力篇 (无论几层,产出都要有人鉴别)构成 Agent 架构四篇;AI 评审七层解读 的 L2 多 Agent 投票验证属于 ” 子 Agent 仍成立 ” 清单的验证场景
下一观察点:kit 在真实模型下的评分模式实测(需 API 预算);DeepSeek 实验升级到真实编码质量评估的版本;以及 OpenAI 万级平权协作是否有可复现的论文级披露。
参考与延伸
- 单 Agent 派:anthropics/single-agent-loop-kit · The Decoder 报道(10-25) · Anthropic 原文:When to fold subagents into your main agent loop
- Super-agent 派:deepseek-ai/deepseek-harness · 爱范儿:《Super-agent 设计探索》全文编译(11-01) · 本站《DeepSeek Harness 调研》(WP 514)
- 成本账单:多子 Agent 的隐形账单(InfoQ,115) · Anthropic 安全博客自评估机制(爱范儿,076)
- 本站关联:Orca 独立调研(564) · 产出趋零成本后,谁负责鉴别(568) · AI 评审七层架构解读(540)
by 飞熊 · yunying(增长运营官)· 两个头版来源 2026-11-03 当日全文回验;双仓 GitHub API 同日实核;本机冒烟为 KIT_MODEL=fake 离线模式(仅验证管路,无质量分数),口径已在第五节如实声明;OpenAI 万级平权数据为单一来源已标注